- Published on
LeetCode Easy 20: Valid Parentheses em Python
- Authors
- Name
- Michel Fernandes
- @michelpf
Neste post, o problema 20 do LeetCode, Valid Parentheses, é resolvido em Python de quatro formas. O post faz parte da série LeetCode Easy, que traz toda sexta um problema de nível fácil (Easy), da solução mais simples até a mais eficiente. O post anterior tratou do problema 14, o Longest Common Prefix. Os problemas 15 a 19 são de nível médio (Medium) e ficam fora da série. Cada versão tem código comentado e testado, com a análise de complexidade em notação Big O. Os posts ficam reunidos na tag leetcode-easy.
O problema
O Valid Parentheses recebe um texto s feito só de parênteses (), colchetes [] e chaves {}. A função deve responder True se o texto é válido e False se não é. Um texto é válido quando todo símbolo aberto é fechado pelo símbolo do mesmo tipo, na ordem certa. O último que abriu é o primeiro que precisa fechar. Também não pode sobrar fechamento sem abertura, nem abertura sem fechamento.
Assim, "()[]{}" e "([])" são válidos. Já "(]" é inválido, porque o parêntese é fechado por um colchete. E "([)]" também é inválido. Os tipos até batem na contagem, mas o parêntese fecha antes do colchete que abriu depois dele.
O enunciado garante que o texto tem de 1 a 10.000 caracteres e que só aparecem os seis símbolos.
![Quatro exemplos lado a lado, cada símbolo em uma caixa. Em "()[]{}" e "([])", todas as caixas estão em verde, com arcos ligando cada abertura ao seu fechamento, e o título diz válido. Em "(]", as duas caixas estão em vermelho, ligadas por um arco tracejado. Em "([)]", o colchete aberto e o parêntese fechado estão em vermelho, ligados por um arco tracejado, e o título diz inválido](/static/images/leetcode-20-valid-parentheses-problema.png)
Figura 1. Exemplos do enunciado. Em verde, os pares que fecham certo. Em vermelho, o fechamento que não bate com a abertura mais recente. Elaborado para este post.
Big O em poucas palavras
A notação Big O descreve como o custo de um algoritmo cresce quando a entrada cresce. Neste problema, a entrada tem uma medida só: n, a quantidade de caracteres do texto. O(n) quer dizer que o trabalho cresce na mesma proporção do texto. O(n²) quer dizer que, quando o texto dobra de tamanho, o trabalho fica cerca de quatro vezes maior.
A complexidade de espaço segue a mesma ideia para a memória extra que o algoritmo usa. O(n) de espaço quer dizer que essa memória pode crescer junto com o texto.
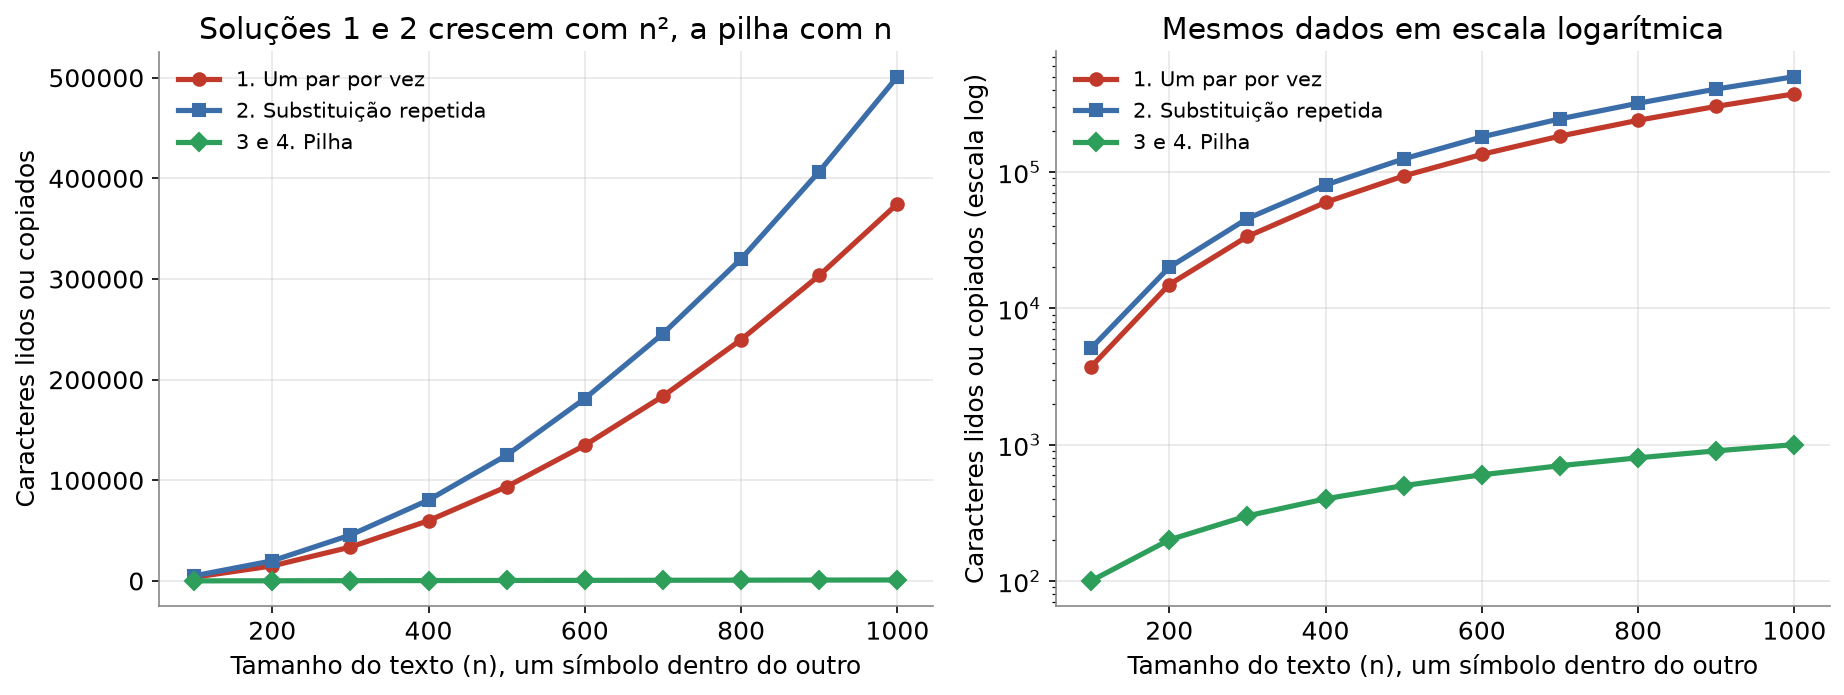
Figura 2. Caracteres lidos ou copiados por cada solução, contados executando a lógica das soluções sobre textos com um símbolo dentro do outro, como "([{([{...}])}])". As soluções 1 e 2 crescem com o quadrado de n. As pilhas leem cada caractere uma vez. Elaborado para este post.
Solução 1: força bruta, um par por vez
Todo texto válido que não está vazio tem pelo menos um par vizinho, como (), [] ou {}, em algum lugar. Ao remover esse par, o resto continua válido. A força bruta usa essa ideia ao pé da letra. Ela procura, a partir do começo, o primeiro par vizinho e o remove. Depois recomeça a busca do início. Se o texto ficar vazio, ele era válido. Se a busca não achar mais pares e ainda sobrar algum caractere, ele era inválido.
def valido_um_par_por_vez(s: str) -> bool:
    # Procura do começo o primeiro par vizinho e o remove. Repete até não achar mais
    pares = {"()", "[]", "{}"}
    achou = True
    while achou:
        achou = False
        for i in range(len(s) - 1):
            if s[i : i + 2] in pares:
                s = s[:i] + s[i + 2 :]  # remove o par e recomeça a busca
                achou = True
                break
    # Se sobrou algum caractere, ele não tem par
    return s == ""
Os textos do Python não podem ser alterados. Por isso, cada remoção monta um texto novo com o pedaço antes do par e o pedaço depois dele.
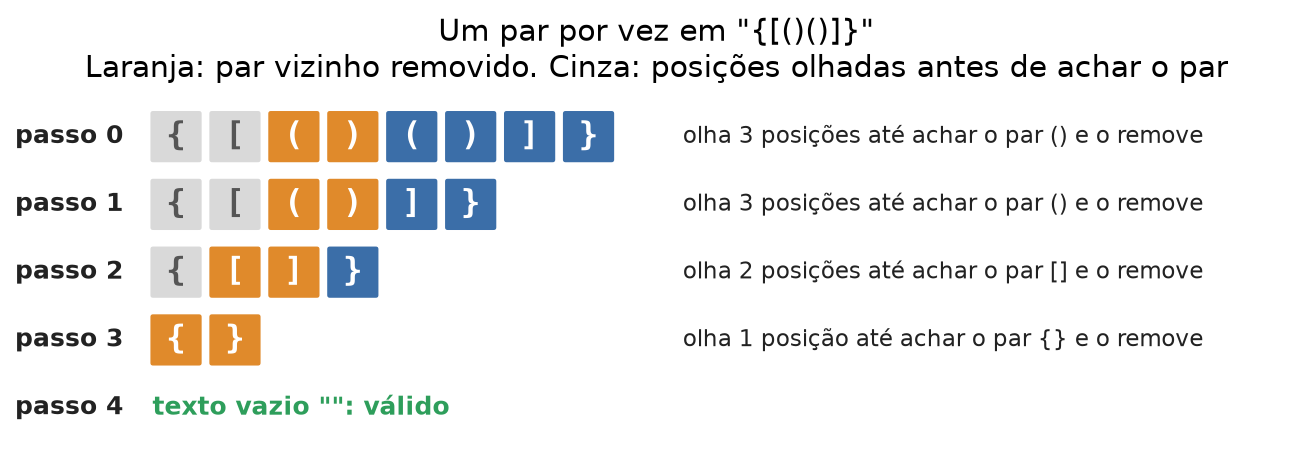
Figura 3. Um par por vez em "{[()()]}". A cada passo, a busca recomeça do início, passa pelas posições em cinza e remove o par em laranja. Elaborado para este post.
Complexidade de tempo: O(n²). Um texto de n caracteres tem até n/2 pares para remover. Para cada par, a busca pode passar por quase todo o texto, e a remoção copia o texto inteiro. No pior caso, um texto com um símbolo dentro do outro, como "([{([{...}])}])", o único par vizinho fica no meio, e cada busca anda metade do texto. Com 1.000 caracteres, foram cerca de 375 mil caracteres lidos ou copiados, como mostra a Figura 2.
Complexidade de espaço: O(n). Cada remoção cria uma cópia do texto.
O desperdício está em recomeçar do zero depois de cada remoção e em copiar o texto a cada par. A próxima versão remove muitos pares de uma vez.
Solução 2: substituição repetida
A segunda solução usa o método str.replace, que troca todas as ocorrências de um trecho por outro. Ela troca "()", "[]" e "{}" por texto vazio, nessa ordem. Isso forma uma rodada. As rodadas se repetem até o texto parar de mudar. No fim, o texto vazio indica que tudo fechou.
def valido_substituicao(s: str) -> bool:
    # Remove todos os pares vizinhos de uma vez, até o texto parar de mudar
    anterior = None
    while s != anterior:
        anterior = s
        s = s.replace("()", "").replace("[]", "").replace("{}", "")
    return s == ""
Em "()[]{}", uma rodada só já esvazia o texto. Quando um símbolo está dentro do outro, cada remoção revela um par novo que só a rodada seguinte vai pegar, como mostra a Figura 4.
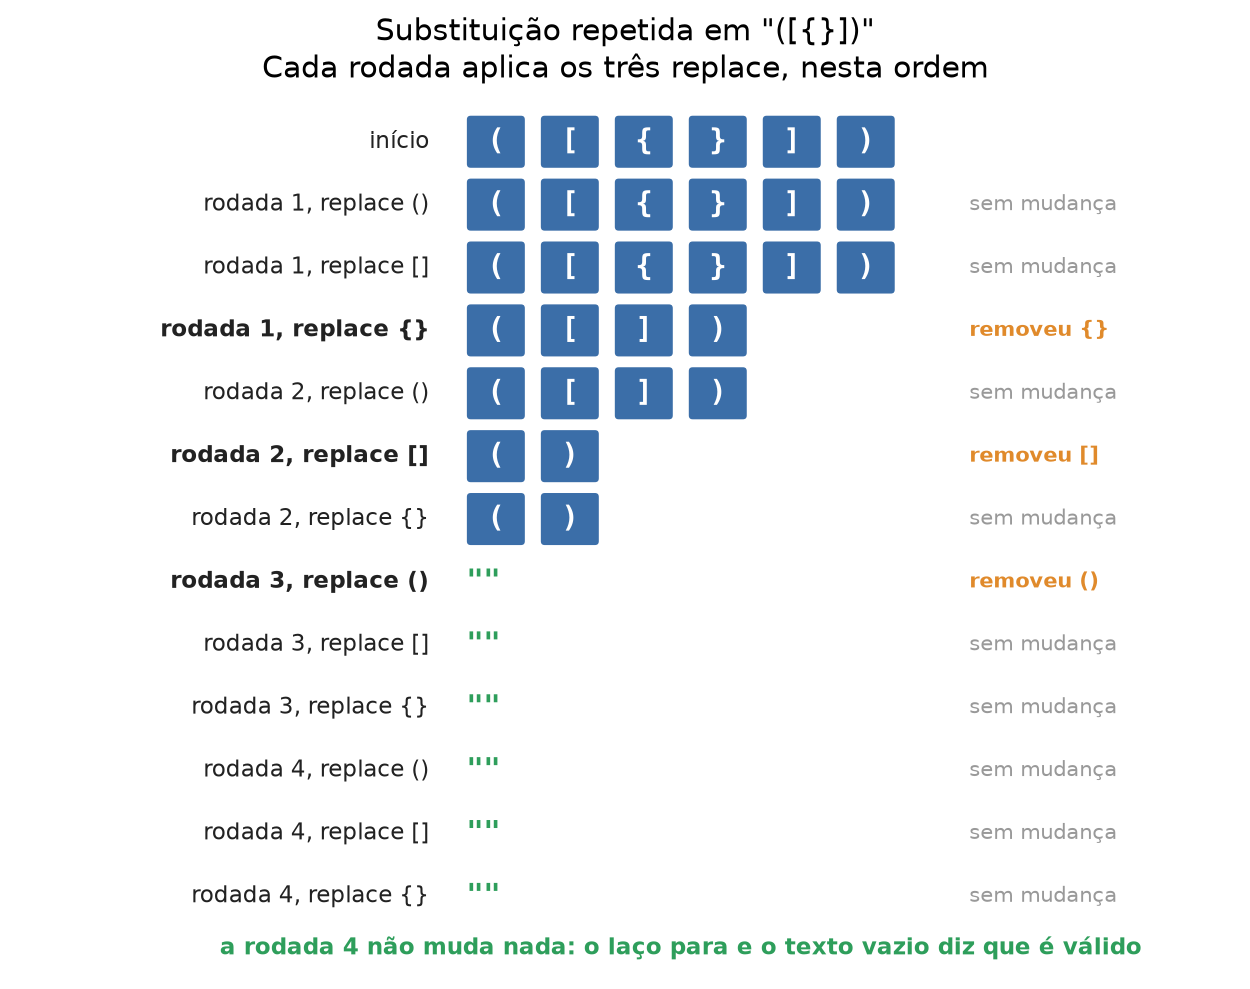
Figura 4. Substituição repetida em "([{}])". São três rodadas com mudança e uma quarta que só confirma que nada mudou. Elaborado para este post.
Complexidade de tempo: O(n²). Cada replace lê o texto inteiro. No pior caso, com um símbolo dentro do outro, cada rodada remove no máximo dois pares, e o número de rodadas cresce junto com n. Com 1.000 caracteres encaixados, foram 335 rodadas. Na contagem da Figura 2, esta solução lê até mais caracteres que a solução 1.
Complexidade de espaço: O(n). Cada replace cria um texto novo.
Mesmo lendo mais caracteres, esta solução foi muito mais rápida que a primeira nas medições, porque o replace roda em C, a linguagem em que o Python é escrito. Ainda assim, ela continua relendo o texto a cada rodada. As próximas versões leem cada caractere uma vez só.
Solução 3: pilha com if
Uma pilha é uma estrutura em que o último item guardado é o primeiro a sair, como uma pilha de pratos. É a mesma regra do problema: o último símbolo aberto é o primeiro que precisa fechar. Em Python, uma lista serve de pilha. O append coloca um item no topo e o pop tira o item do topo.
A terceira solução lê o texto uma vez, da esquerda para a direita. Cada abertura vai para o topo da pilha. Cada fechamento tira o topo e confere se ele é a abertura do mesmo tipo. A conferência é feita com um if para cada tipo.
def valido_pilha_if(s: str) -> bool:
    pilha = []
    for c in s:
        if c in "([{":
            pilha.append(c)  # abertura: guarda no topo da pilha
        elif not pilha:
            return False  # fechamento sem nenhuma abertura pendente
        else:
            topo = pilha.pop()
            # Confere, tipo por tipo, se o topo abre o que c fecha
            if c == ")" and topo != "(":
                return False
            elif c == "]" and topo != "[":
                return False
            elif c == "}" and topo != "{":
                return False
    # Válido só se nenhuma abertura ficou sem fechar
    return not pilha
No fim, a pilha precisa estar vazia. Se sobrou alguma abertura, como em "(()", o texto é inválido.
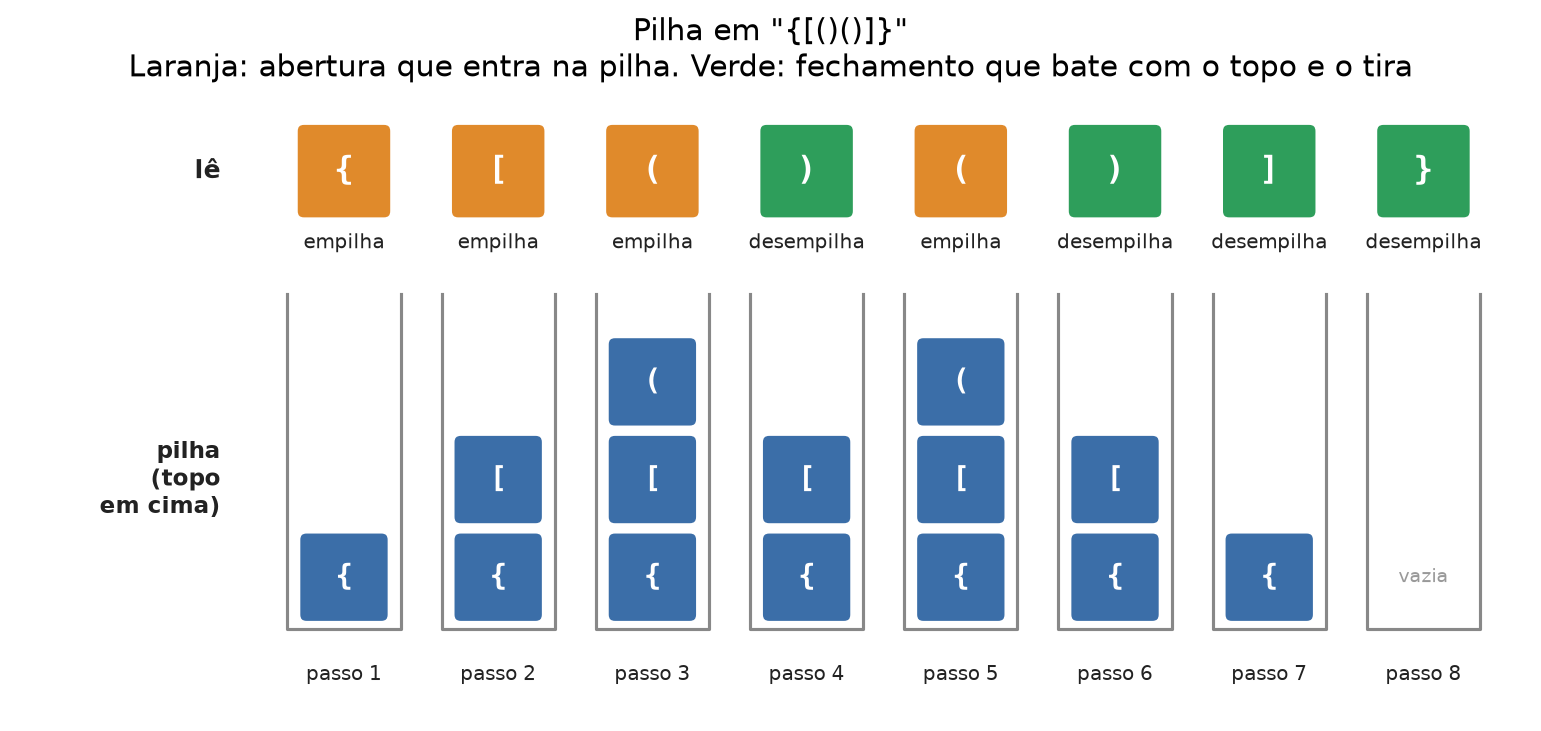
Figura 5. A pilha em "{[()()]}". Cada abertura entra no topo, cada fechamento tira o topo, e a pilha termina vazia. Elaborado para este post.
Complexidade de tempo: O(n). Cada caractere é lido uma vez e entra ou sai da pilha uma vez. O append e o pop no fim da lista têm custo constante.
Complexidade de espaço: O(n). Em um texto só de aberturas, como "((((", a pilha guarda todos os caracteres.
A solução já é linear, mas cada fechamento pode passar por até três comparações de tipo. Para incluir um quarto tipo de símbolo, seria preciso mais um elif. A próxima versão troca essa cadeia de if por um dicionário.
Solução 4: pilha com dicionário
A quarta solução guarda os pares em um dicionário. A chave é o fechamento e o valor é a abertura que ele espera. Assim, cada fechamento faz uma consulta só, pares[c], e compara o resultado com o topo da pilha. A função também desiste logo no começo quando o tamanho do texto é ímpar, porque um texto com número ímpar de caracteres sempre deixa algum sem par.
def valido_pilha_dicionario(s: str) -> bool:
    if len(s) % 2 == 1:
        return False  # tamanho ímpar nunca fecha todos os pares
    # Para cada fechamento, a abertura que ele espera
    pares = {")": "(", "]": "[", "}": "{"}
    pilha = []
    for c in s:
        if c in pares:
            # Fechamento: o topo da pilha precisa ser a abertura certa
            if not pilha or pilha.pop() != pares[c]:
                return False
        else:
            pilha.append(c)  # abertura: guarda no topo da pilha
    return not pilha
O not pilha antes do pop evita o erro de tirar item de uma pilha vazia, que aconteceria em textos como ")(". Com a pilha vazia, not pilha já é verdadeiro, a função devolve False e o pop nem é chamado.
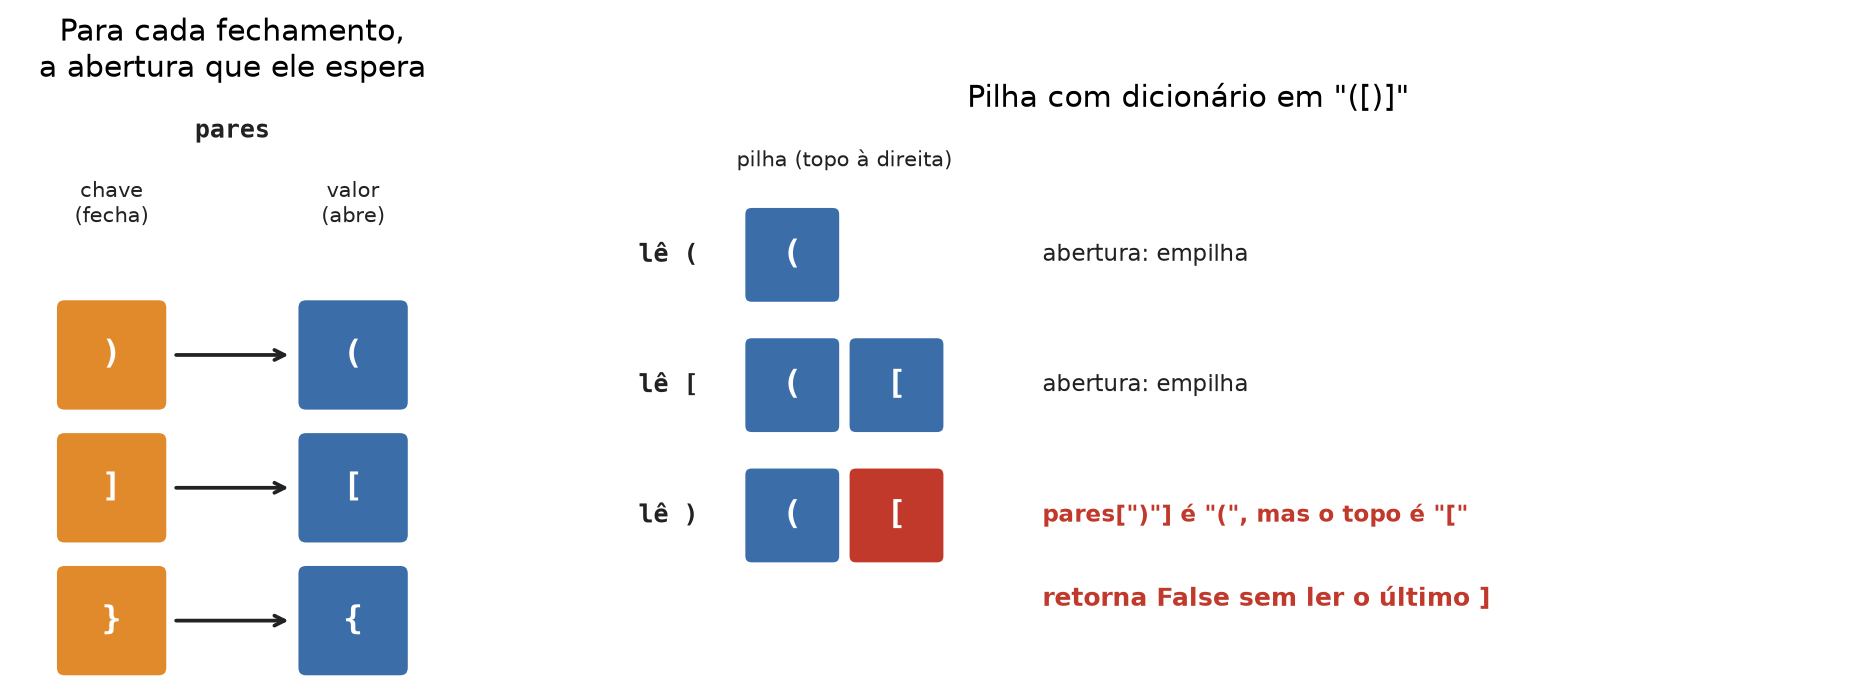
Figura 6. O dicionário de pares e a execução em "([)]". O erro aparece no terceiro caractere, e a função para ali. Elaborado para este post.
Complexidade de tempo: O(n). A consulta a um dicionário tem custo constante, e cada caractere é lido uma vez.
Complexidade de espaço: O(n), pela pilha. O dicionário tem sempre três itens.
A complexidade é a mesma da solução 3. A melhora está no trabalho por caractere: uma consulta ao dicionário no lugar de até três comparações. O código também fica mais curto, e um tipo novo de símbolo entra com uma linha a mais no dicionário.
Testes
O código das quatro funções deste post é o mesmo do script de testes, executado em Python 3.13.5. O script roda 16 casos fixos em cada solução: os 5 exemplos do enunciado, o exemplo das figuras e 10 casos extras, como um caractere só, fechamento antes da abertura, abertura sobrando, tipos trocados e textos de 10.000 caracteres. Depois, roda 5.000 textos sorteados. Metade é montada para ser válida, e em metade desses um caractere é trocado ao acaso. A outra metade é sorteada sem regra nenhuma. Cada resposta é comparada com uma verificação independente, escrita a partir da definição de texto válido, sem pilha explícita. Dos 5.000 textos, 1.491 eram válidos. Ao todo, foram 20.064 verificações (16 × 4 + 5.000 × 4), todas corretas.
Comparação
A Figura 7 mostra o tempo de cada solução pelo tamanho do texto. Para cada tamanho, de 1.000 a 10.000 caracteres, os símbolos ficam um dentro do outro, como "([{([{...}])}])". Esse texto é válido, então todas as soluções precisam ler até o fim. Cada medida chama a função 1 vez na solução 1, 5 vezes na solução 2 e 200 vezes nas soluções 3 e 4. Cada ponto é o menor tempo de 7 medidas, dividido pelo número de chamadas.
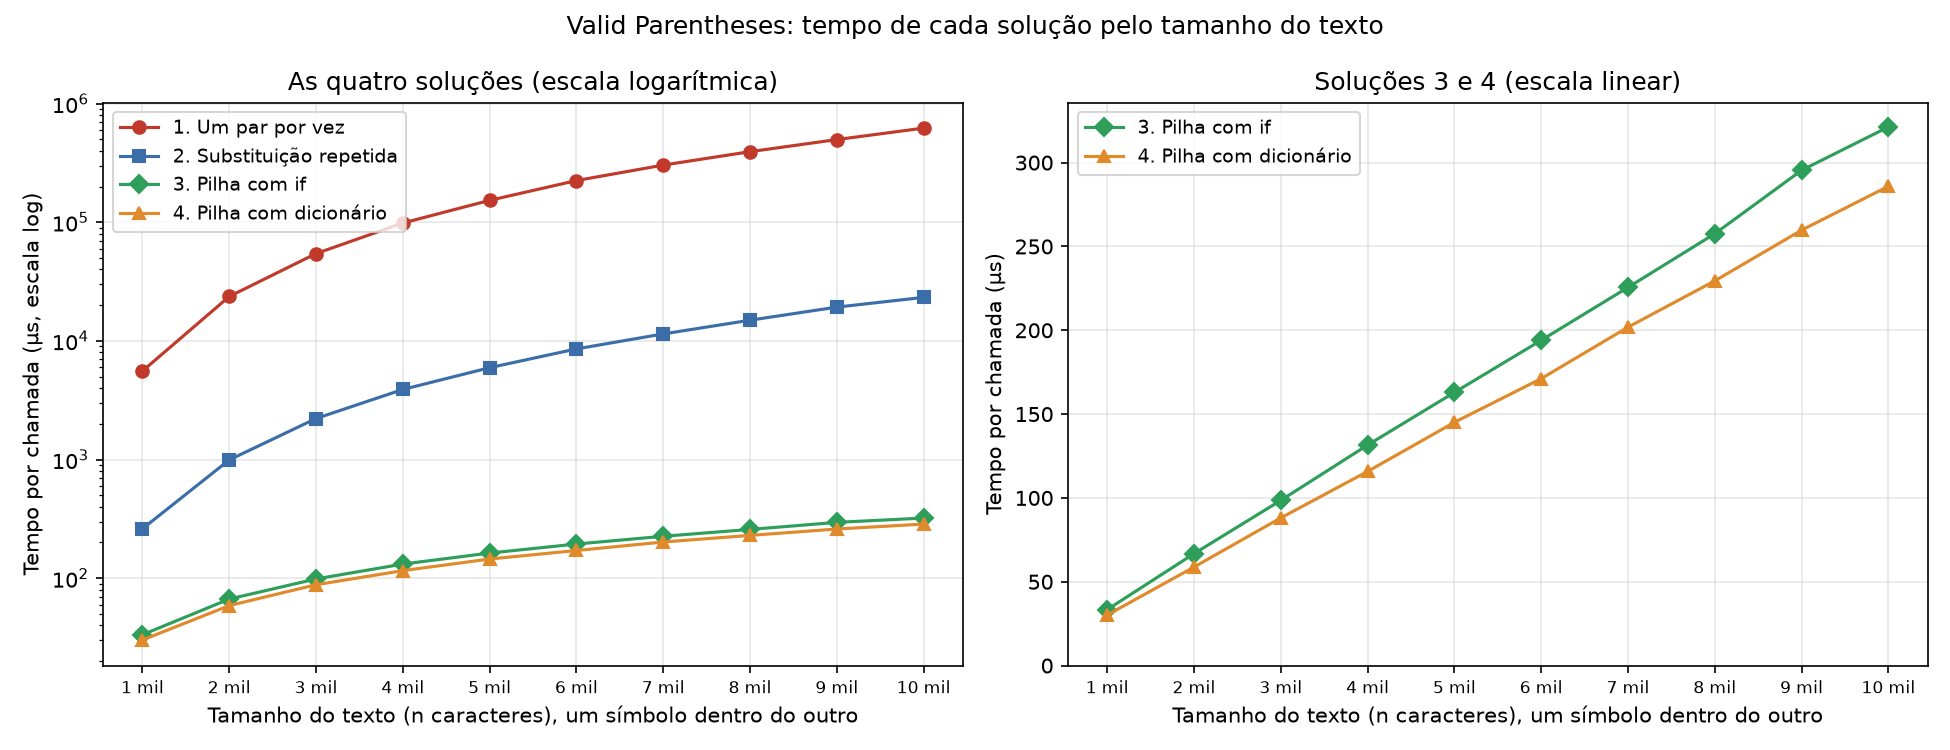
Figura 7. Tempo por chamada de cada solução do Valid Parentheses, em microssegundos, para textos encaixados de 1.000 a 10.000 caracteres. À esquerda, as quatro soluções em escala logarítmica. À direita, só as soluções 3 e 4. Gráfico elaborado para este post com o script de testes, em Python 3.13.5.
Com 10.000 caracteres, o tamanho máximo do enunciado, a solução 1 levou cerca de 621 ms por chamada. A substituição repetida levou 23 ms, a pilha com if levou 321 µs e a pilha com dicionário levou 286 µs. A força bruta ficou cerca de 2.200 vezes mais lenta que a solução 4. A substituição repetida ficou cerca de 80 vezes mais lenta.
As curvas da esquerda mostram o efeito do O(n²). Quando o texto vai de 1.000 para 10.000 caracteres, dez vezes maior, a solução 1 fica cerca de 110 vezes mais lenta e a solução 2 cerca de 90 vezes. As duas pilhas ficam cerca de 10 vezes mais lentas, na mesma proporção do texto.
A solução 2 lê mais caracteres que a solução 1, como mostra a Figura 2, e mesmo assim foi de 21 a 27 vezes mais rápida. O motivo é o mesmo dos posts anteriores da série. O replace é uma função interna do Python, escrita em C, e passa pelos caracteres muito mais rápido que um laço em Python. Entre as pilhas, a diferença é pequena. A pilha com dicionário foi de 11% a 14% mais rápida em todos os tamanhos, por fazer menos comparações em cada fechamento.
| Abordagem | Tempo | Espaço | Observação |
|---|---|---|---|
| Um par por vez | O(n²) | O(n) | Recomeça a busca e copia o texto a cada par. Levou 621 ms com 10.000 caracteres |
| Substituição repetida | O(n²) | O(n) | Código curto e replace em C, mas relê o texto a cada rodada. Levou 23 ms |
| Pilha com if | O(n) | O(n) | Lê cada caractere uma vez, com até três comparações por fechamento |
| Pilha com dicionário | O(n) | O(n) | Uma consulta por fechamento e saída rápida em tamanho ímpar. Mais rápida em todos os tamanhos |
A solução 4 é a mais rápida e a mais fácil de estender para novos tipos de símbolo. A solução 2 tem o código mais curto, mas o tempo dela cresce com o quadrado do tamanho do texto.
Próximo post da série
O próximo post da série LeetCode Easy, na sexta, 27/11, trata do problema 21, Merge Two Sorted Lists. Ele pede para juntar duas listas ligadas já ordenadas em uma lista só, também ordenada.
Os links da Amazon neste post são de afiliado: se você comprar por eles, recebo uma comissão, sem custo extra para você.
Para saber mais
- Problema: 20. Valid Parentheses, LeetCode.
- Post anterior da série: LeetCode Easy 14: Longest Common Prefix em Python.
- Documentação: Usando listas como pilhas, tutorial oficial do Python. Mostra o
appende opopusados nas soluções 3 e 4. - Documentação:
str.replace, documentação oficial do Python, usada na solução 2. - Documentação: módulo
timeit, documentação oficial do Python. É o módulo usado para medir os tempos deste post. - Livro: Entendendo Algoritmos: um guia ilustrado para programadores e outros curiosos, de Aditya Y. Bhargava. 2ª edição, Novatec, 2026. ISBN 978-8575229293. Explica a notação Big O com ilustrações e exemplos em Python 3.
- Livro: Cracking the Coding Interview: 189 Programming Questions and Solutions, de Gayle Laakmann McDowell. 6ª edição, CareerCup, 2015. ISBN 978-0984782857. Em inglês, com 189 questões de entrevista resolvidas e uma seção sobre pilhas e filas.