- Published on
LeetCode Easy 13: Roman to Integer em Python
- Authors
- Name
- Michel Fernandes
- @michelpf
Neste post, o problema 13 do LeetCode, Roman to Integer, é resolvido em Python de quatro formas. O post faz parte da série LeetCode Easy, que traz toda sexta um problema de nível fácil (Easy), da solução mais simples até a mais eficiente. O post anterior tratou do problema 9, o Palindrome Number. Cada versão tem código comentado e testado, com a análise de complexidade em notação Big O. Os posts ficam reunidos na tag leetcode-easy.
O problema
O Roman to Integer recebe um texto s com um número escrito em algarismos romanos e pede o valor dele como número inteiro. O romano XIV, por exemplo, deve virar 14.
Os romanos usam sete símbolos: I vale 1, V vale 5, X vale 10, L vale 50, C vale 100, D vale 500 e M vale 1000. Em geral, os símbolos aparecem do maior para o menor e os valores são somados. O III vale 3 e o LVIII vale 58 (50 + 5 + 1 + 1 + 1).
A exceção são seis combinações em que um símbolo menor vem antes de um maior e é subtraído dele. O IV vale 4 e o IX vale 9. O XL vale 40 e o XC vale 90. O CD vale 400 e o CM vale 900. Com isso, o MCMXCIV vale 1994: M (1000) + CM (900) + XC (90) + IV (4).
O enunciado garante que o texto é sempre um romano válido, com 1 a 15 símbolos, e que o valor fica entre 1 e 3999.
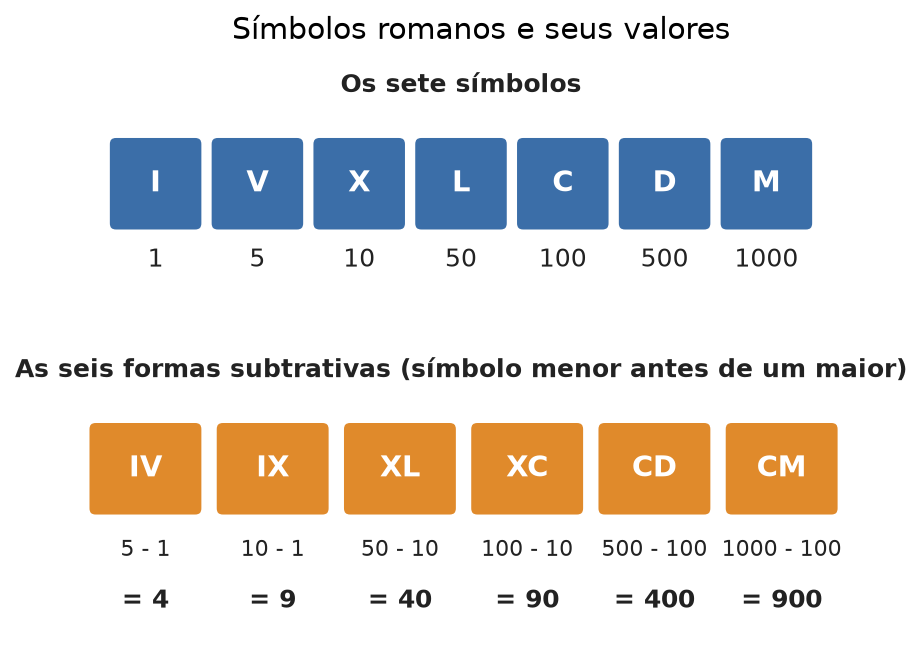
Figura 1. Os sete símbolos romanos e as seis formas subtrativas, com a conta de cada uma. Elaborado para este post.
Big O em poucas palavras
A notação Big O descreve como o custo de um algoritmo cresce quando a entrada cresce. Neste problema, a entrada é o texto s, e o tamanho dele, chamado aqui de n, é a quantidade de símbolos. O(n) quer dizer que o trabalho cresce na mesma proporção de n. Pelo enunciado, n vai no máximo até 15.
A complexidade de espaço segue a mesma ideia para a memória extra que o algoritmo usa. O(1) quer dizer que essa memória não muda com o tamanho do texto.
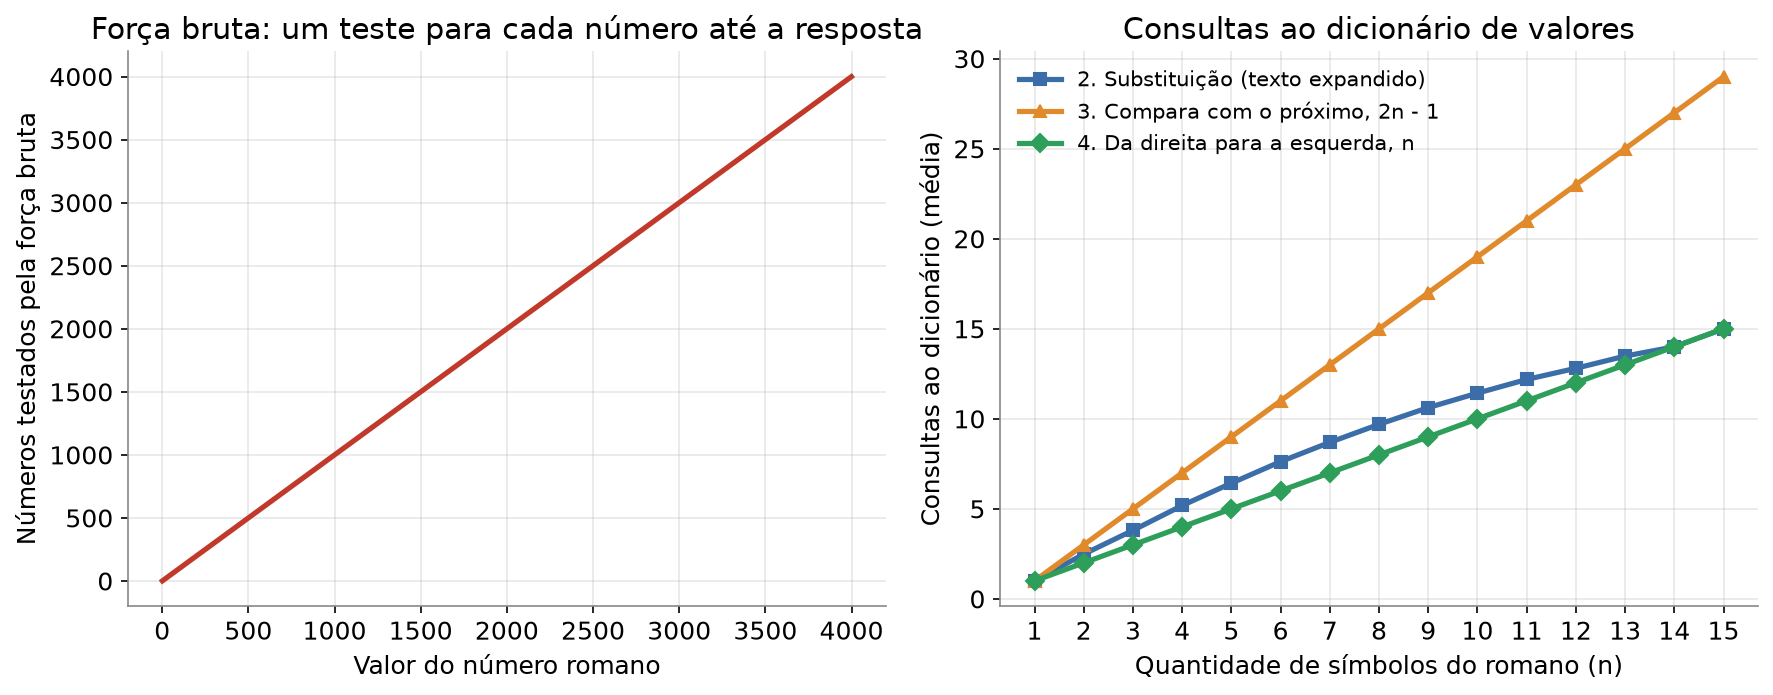
Figura 2. À esquerda, a força bruta testa um número para cada valor até chegar à resposta. À direita, a média de consultas ao dicionário de valores de cada solução, contada executando a lógica das soluções sobre os 3.999 romanos válidos. Elaborado para este post.
Solução 1: força bruta
A força bruta usa o caminho inverso. Converter um inteiro em romano é mais fácil, porque basta tirar do número o maior valor possível da tabela, escrever o símbolo e repetir. A função auxiliar para_romano faz isso com as sete letras e as seis formas subtrativas. A solução então testa cada número de 1 a 3999, converte em romano e para quando o resultado é igual a s.
def para_romano(n: int) -> str:
    # Converte um inteiro de 1 a 3999 em romano, do maior símbolo para o menor
    tabela = [(1000, "M"), (900, "CM"), (500, "D"), (400, "CD"), (100, "C"), (90, "XC"),
              (50, "L"), (40, "XL"), (10, "X"), (9, "IX"), (5, "V"), (4, "IV"), (1, "I")]
    partes = []
    for valor, simbolo in tabela:
        while n >= valor:
            partes.append(simbolo)
            n -= valor
    return "".join(partes)
def romano_forca_bruta(s: str) -> int:
    # Testa cada número de 1 a 3999 até achar o que escreve o mesmo romano
    for n in range(1, 4000):
        if para_romano(n) == s:
            return n
    return 0
Para "III", a busca testa 1 (I), 2 (II) e 3 (III), e para no terceiro teste. Para "MMMCMXCIX", que vale 3999, ela converte os 3.999 números antes de achar a resposta.
Complexidade de tempo: O(N), em que N é o valor do romano. A busca faz uma conversão para cada número até chegar a N, e cada conversão percorre a tabela de 13 valores e monta até 15 símbolos. Como N vai até 3999, o pior caso tem milhares de conversões para ler um texto de no máximo 15 símbolos.
Complexidade de espaço: O(1). Cada conversão monta um romano de até 15 símbolos e descarta em seguida.
A força bruta não olha para os símbolos de s, só para o resultado de cada tentativa. As próximas versões leem o texto diretamente.
Solução 2: trocar as subtrações por somas
As seis formas subtrativas são a única parte difícil do problema. Se elas forem escritas só com somas, o valor do romano vira a soma dos valores de cada símbolo. O IV pode ser escrito como IIII, e o CM como DCCCC. A função faz as seis trocas com str.replace e depois soma tudo.
def romano_substituicao(s: str) -> int:
    # Troca cada forma subtrativa por uma forma só de somas
    # Exemplo: IV vira IIII, e CM vira DCCCC
    trocas = [("IV", "IIII"), ("IX", "VIIII"), ("XL", "XXXX"),
              ("XC", "LXXXX"), ("CD", "CCCC"), ("CM", "DCCCC")]
    for antes, depois in trocas:
        s = s.replace(antes, depois)
    valores = {"I": 1, "V": 5, "X": 10, "L": 50, "C": 100, "D": 500, "M": 1000}
    # Sem formas subtrativas, basta somar o valor de cada símbolo
    return sum(valores[c] for c in s)
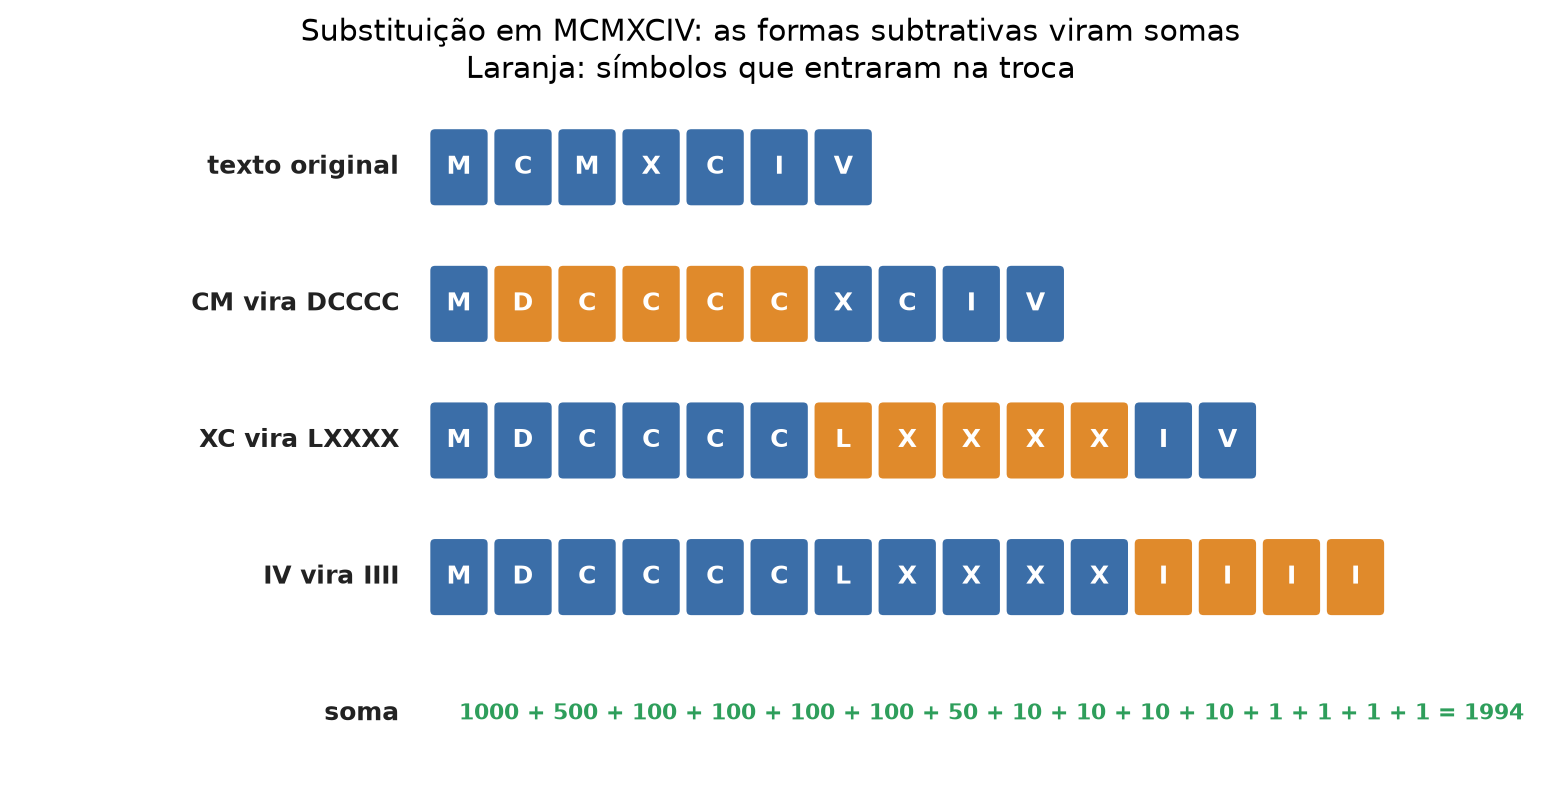
Figura 3. As trocas em MCMXCIV. O texto passa de 7 para 16 símbolos, e a soma de todos eles dá 1994. Elaborado para este post.
Complexidade de tempo: O(n). Cada uma das seis trocas percorre o texto uma vez, e a soma percorre o texto expandido. Seis passadas sobre o texto ainda crescem na proporção de n, e na notação Big O a constante 6 é descartada.
Complexidade de espaço: O(n). Cada replace cria uma cópia nova do texto, e o texto expandido pode ficar maior que o original. O MCMXCIV, por exemplo, foi de 7 para 16 símbolos.
A solução é curta, mas lê o texto várias vezes e cria cópias. A próxima versão resolve tudo em uma passada, sem cópias.
Solução 3: comparar com o próximo símbolo
Nas formas subtrativas, o símbolo subtraído é sempre menor que o símbolo seguinte. Em todos os outros casos, o símbolo é maior ou igual ao seguinte e é somado. A regra completa cabe em uma comparação: se o símbolo atual vale menos que o próximo, ele é subtraído do total, senão é somado.
def romano_proximo(s: str) -> int:
    valores = {"I": 1, "V": 5, "X": 10, "L": 50, "C": 100, "D": 500, "M": 1000}
    total = 0
    for i in range(len(s)):
        atual = valores[s[i]]
        # Se o próximo símbolo vale mais, o atual é subtraído
        if i + 1 < len(s) and atual < valores[s[i + 1]]:
            total -= atual
        else:
            total += atual
    return total
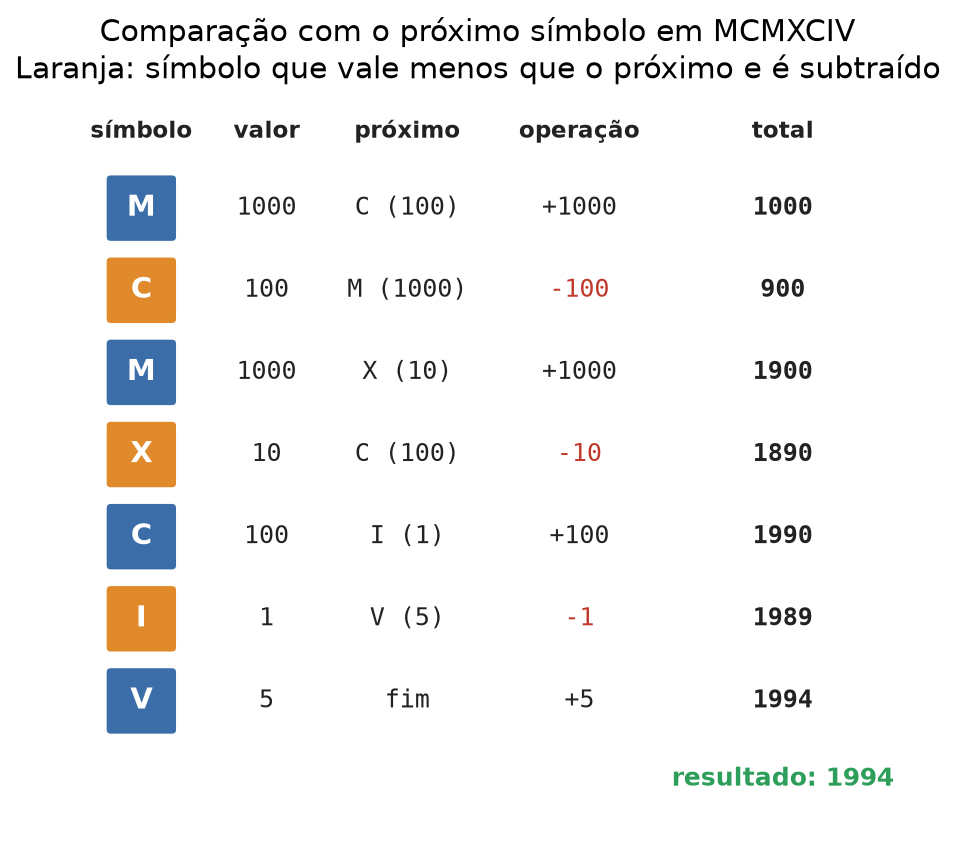
Figura 4. Comparação com o próximo símbolo em MCMXCIV. C antes de M, X antes de C e I antes de V são subtraídos. Elaborado para este post.
O último símbolo não tem próximo, e o teste i + 1 < len(s) garante que ele seja sempre somado.
Complexidade de tempo: O(n). O laço passa uma vez por cada símbolo.
Complexidade de espaço: O(1). O dicionário tem sempre sete chaves, e o código guarda só o total e a posição.
A solução consulta o dicionário duas vezes para quase todos os símbolos, uma como atual e outra como próximo. São 2n - 1 consultas para um texto de n símbolos. A próxima versão guarda o valor já consultado e faz uma consulta por símbolo.
Solução 4: ler da direita para a esquerda
Lendo o texto de trás para frente, a mesma regra pode ser aplicada com o valor que já foi visto. A variável anterior guarda o valor do símbolo da direita, que acabou de ser lido. Se o símbolo atual vale menos que ele, é subtraído, senão é somado. Cada símbolo é consultado no dicionário uma vez só.
def romano_direita_esquerda(s: str) -> int:
    valores = {"I": 1, "V": 5, "X": 10, "L": 50, "C": 100, "D": 500, "M": 1000}
    total = 0
    anterior = 0  # valor do símbolo à direita do atual
    # Percorre o texto de trás para frente
    for c in reversed(s):
        atual = valores[c]
        # Menor que o vizinho da direita: subtrai, senão soma
        if atual < anterior:
            total -= atual
        else:
            total += atual
        anterior = atual
    return total
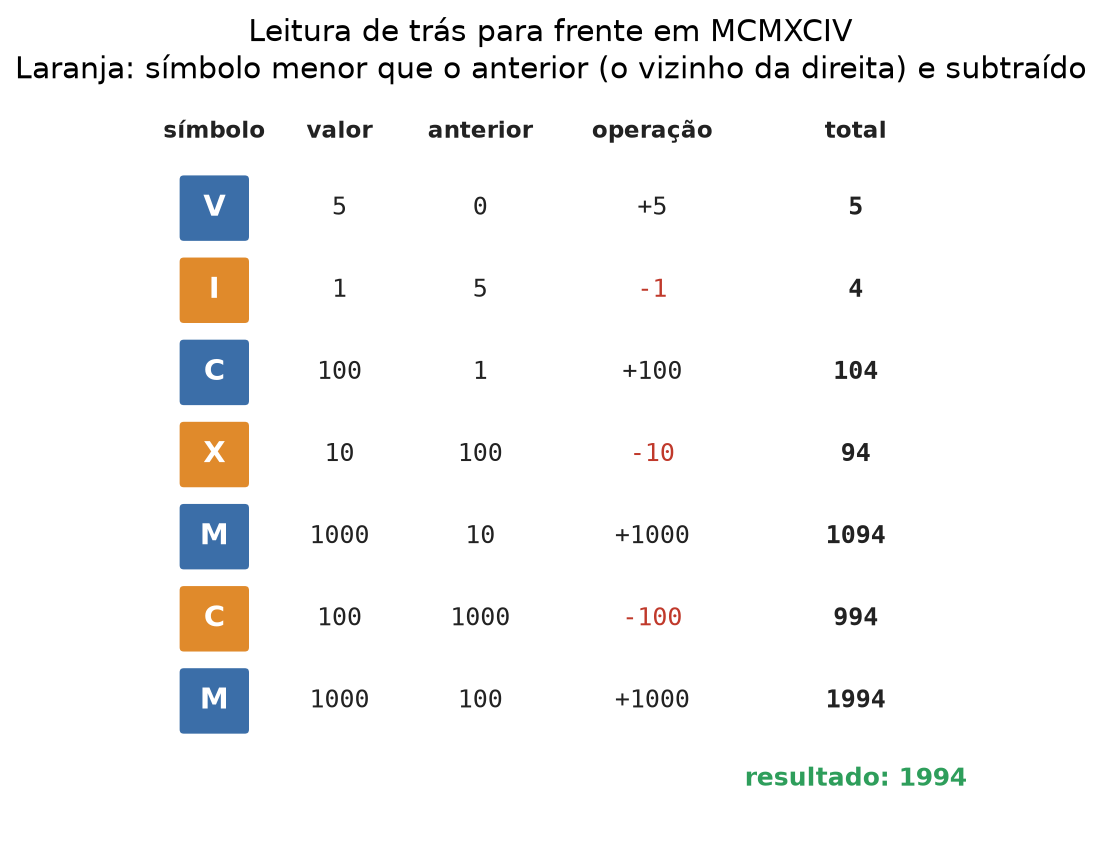
Figura 5. Leitura de trás para frente em MCMXCIV. O total passa por 5, 4, 104, 94, 1094, 994 e termina em 1994. Elaborado para este post.
A função reversed não cria uma cópia do texto. Ela devolve um iterador que entrega os símbolos do último para o primeiro.
Complexidade de tempo: O(n). Uma passada pelo texto, com uma consulta ao dicionário por símbolo.
Complexidade de espaço: O(1). O código guarda só total, anterior e o valor atual.
Na notação Big O, as soluções 3 e 4 empatam. A solução 4 ganha na constante, com metade das consultas ao dicionário e sem o teste de fim do texto a cada volta.
Testes
O código das cinco funções deste post é o mesmo do script de testes, executado em Python 3.13.5. O script roda 16 casos fixos em cada solução: os 3 exemplos do enunciado e 13 casos extras, com o menor e o maior valor, cada uma das seis formas subtrativas, subtrações em sequência e o romano mais longo possível, MMMDCCCLXXXVIII (3888), com 15 símbolos. Depois, roda todos os 3.999 romanos válidos, de I a MMMCMXCIX. Ao todo, foram 16.060 verificações (16 × 4 + 3.999 × 4), todas corretas.
Comparação
A Figura 6 mostra o tempo de cada solução por tamanho do romano. Para cada quantidade de símbolos, de 1 a 15, foram sorteados até 50 romanos válidos daquele tamanho. Cada medida chama a função 200 vezes para cada romano (2 vezes na força bruta, que é muito mais lenta), e cada ponto é o menor tempo de 5 medidas, dividido pelo número de chamadas.
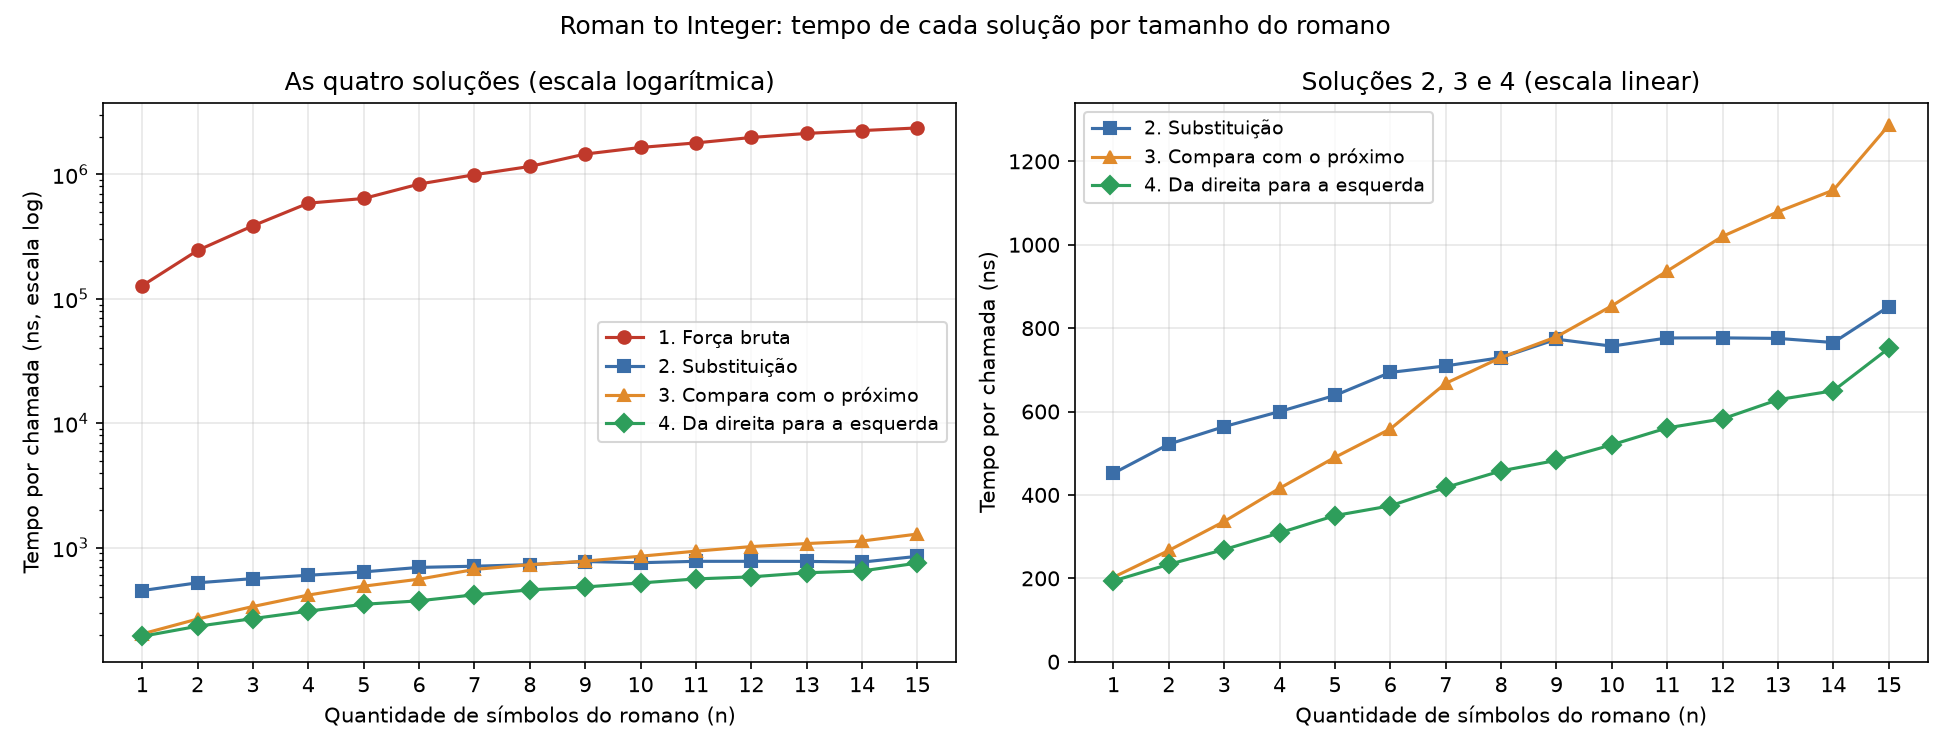
Figura 6. Tempo por chamada de cada solução do Roman to Integer, em nanossegundos, para romanos de 1 a 15 símbolos. À esquerda, as quatro soluções em escala logarítmica. À direita, só as soluções 2, 3 e 4. Gráfico elaborado para este post com o script de testes, em Python 3.13.5.
Com 15 símbolos, a força bruta levou cerca de 2,4 milhões de nanossegundos (2,4 ms) por chamada. A substituição levou 852 ns, a comparação com o próximo levou 1.286 ns e a leitura da direita para a esquerda levou 752 ns. A força bruta ficou cerca de 3 mil vezes mais lenta que a solução 4. O tempo dela cresce com o tamanho do romano porque romanos mais longos costumam ter valores maiores, e a busca precisa testar mais números até chegar neles.
Entre as outras três, o resultado tem uma surpresa. Até 7 símbolos, a substituição foi a mais lenta das três. Com 8 símbolos, empatou com a comparação com o próximo, e daí em diante ficou à frente dela. Com 15 símbolos, ficou cerca de 100 ns atrás da solução 4. O motivo é o mesmo do post do Palindrome Number. As seis chamadas de replace são funções internas do Python, escritas em C, e têm um custo fixo que quase não muda com o tamanho do texto. Já nas soluções 3 e 4 cada volta do laço roda como código Python, e o tempo sobe a cada símbolo. A solução 4 foi a mais rápida em todos os tamanhos.
| Abordagem | Tempo | Espaço | Observação |
|---|---|---|---|
| Força bruta | O(N), N até 3999 | O(1) | Testa os números um a um. Levou 2,4 ms com 15 símbolos |
| Substituição | O(n) | O(n) | Seis passadas e cópias do texto, mas as trocas rodam em C |
| Compara com o próximo | O(n) | O(1) | Uma passada, com 2n - 1 consultas ao dicionário |
| Da direita para a esquerda | O(n) | O(1) | Uma passada e uma consulta por símbolo. Mais rápida em todos os tamanhos |
A solução 4 é a mais rápida e a que menos usa memória. A solução 3 segue a leitura natural, da esquerda para a direita, e por isso costuma ser a mais fácil de explicar em uma entrevista.
Próximo post da série
O próximo post da série LeetCode Easy, na sexta, 06/11, trata do problema 14, Longest Common Prefix. Ele pede o maior começo comum a uma lista de palavras, como "fl" em "flower", "flow" e "flight".
Os links da Amazon neste post são de afiliado: se você comprar por eles, recebo uma comissão, sem custo extra para você.
Para saber mais
- Problema: 13. Roman to Integer, LeetCode.
- Post anterior da série: LeetCode Easy 9: Palindrome Number em Python.
- Documentação:
str.replace, documentação oficial do Python, usada na solução 2. - Documentação:
reversed, documentação oficial do Python, usada na solução 4. - Documentação: módulo
timeit, documentação oficial do Python. É o módulo usado para medir os tempos deste post. - Livro: Entendendo Algoritmos: um guia ilustrado para programadores e outros curiosos, de Aditya Y. Bhargava. 2ª edição, Novatec, 2026. ISBN 978-8575229293. Explica a notação Big O com ilustrações e exemplos em Python 3.
- Livro: Cracking the Coding Interview: 189 Programming Questions and Solutions, de Gayle Laakmann McDowell. 6ª edição, CareerCup, 2015. ISBN 978-0984782857. Em inglês, com 189 questões de entrevista resolvidas e uma seção sobre notação Big O.