- Published on
LeetCode Easy 1: Two Sum em Python, de O(n²) a O(n)
- Authors
- Name
- Michel Fernandes
- @michelpf
Neste post, começo a série LeetCode Easy. Toda semana, um problema de nível fácil (Easy) do LeetCode é resolvido em Python, da solução mais simples até a mais eficiente. Cada versão tem código comentado e testado, com a análise de complexidade em notação Big O. Este é o primeiro post da série, por isso começa pelo problema 1, o Two Sum. O próximo será o problema 9, Palindrome Number. Os problemas 2 a 8 são de nível Medium ou Hard e ficam fora da série. Os posts ficam reunidos na tag leetcode-easy.
O problema
O Two Sum recebe uma lista de inteiros nums e um inteiro target, o alvo. A tarefa é devolver os índices dos dois números da lista cuja soma é igual ao alvo. O enunciado garante que existe exatamente uma resposta. Além disso, o mesmo elemento não pode ser usado duas vezes, e a ordem dos dois índices na resposta não importa.
Por exemplo, para nums = [2, 7, 11, 15] e target = 9, a resposta é [0, 1], porque 2 + 7 = 9. Para nums = [3, 2, 4] e target = 6, a resposta é [1, 2]. O 3 da posição 0 não pode ser somado com ele mesmo, então [0, 0] não vale.
A lista tem de 2 a 10.000 números, e cada valor fica entre -1 bilhão e 1 bilhão. No fim do enunciado, o LeetCode propõe um desafio extra: encontrar um algoritmo mais rápido que O(n²).
Big O em poucas palavras
A notação Big O descreve como o custo de um algoritmo cresce quando a entrada cresce. A letra n é o tamanho da lista. O(n) quer dizer que o trabalho cresce na mesma proporção da lista, ou seja, uma lista duas vezes maior leva cerca de duas vezes mais tempo. O(n²) quer dizer que o trabalho cresce com o quadrado do tamanho. Nesse caso, uma lista duas vezes maior leva cerca de quatro vezes mais tempo. A complexidade de espaço segue a mesma ideia para a memória extra que o algoritmo usa, sem contar a própria lista de entrada.
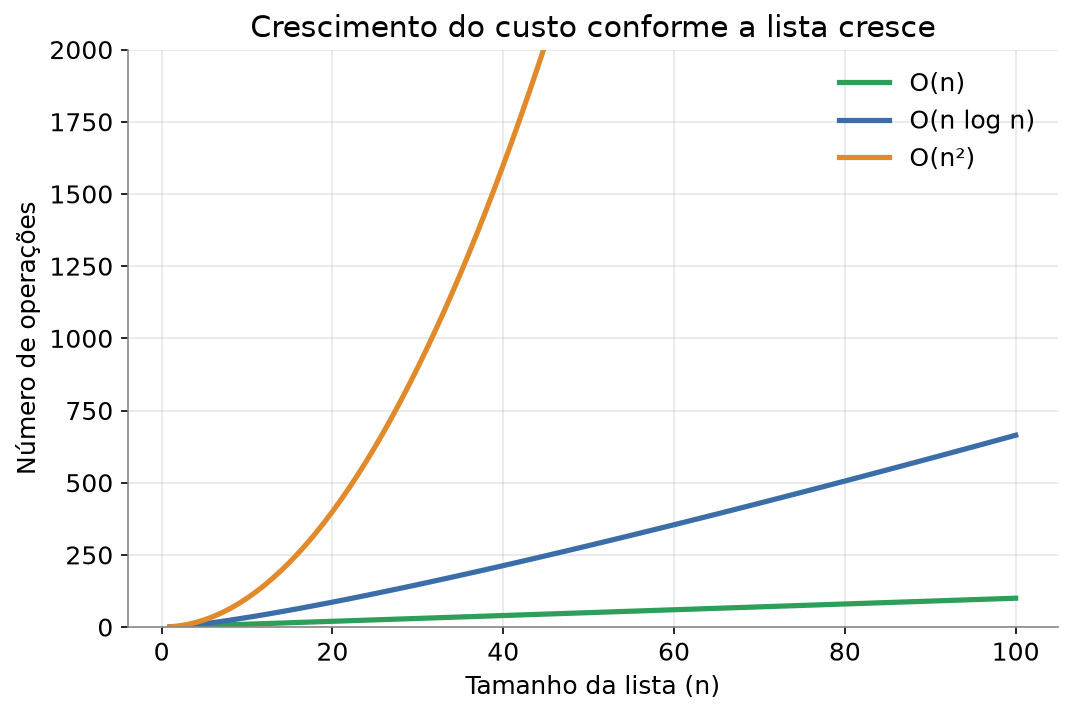
Figura 1. Crescimento do número de operações em O(n), O(n log n) e O(n²) para listas de até 100 números. Elaborado para este post.
Solução 1: força bruta com dois laços
A ideia mais direta é testar todos os pares. O laço externo escolhe o primeiro número, na posição i. O laço interno percorre só as posições depois de i, na variável j. Assim, cada par é testado uma única vez e nenhum número é somado com ele mesmo.
def two_sum_forca_bruta(nums: list[int], target: int) -> list[int]:
    n = len(nums)
    # Testa cada par (i, j) uma única vez, com j sempre depois de i
    for i in range(n):
        for j in range(i + 1, n):
            if nums[i] + nums[j] == target:
                return [i, j]
    # O enunciado garante uma resposta, então esta linha não deve ser alcançada
    return []
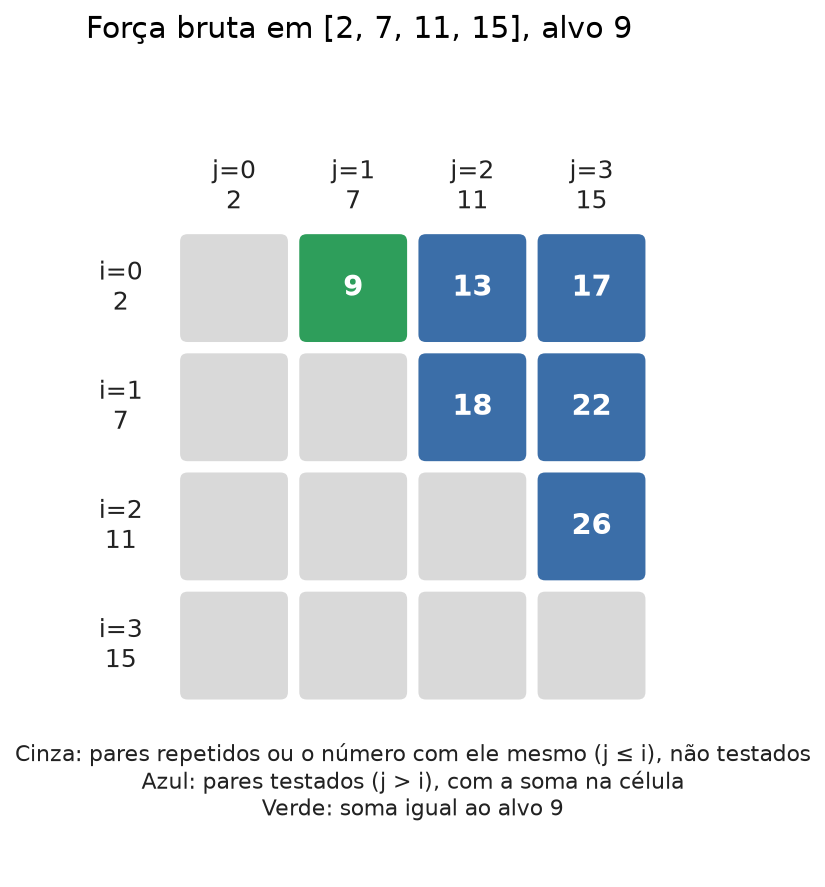
Figura 2. Pares testados pela força bruta em [2, 7, 11, 15] com alvo 9. Só as células com j maior que i são testadas, e o par (0, 1) soma 9. Elaborado para este post.
Complexidade de tempo: O(n²). Para uma lista de n números, existem n × (n - 1) / 2 pares. Com 10.000 números, são 49.995.000 pares, ou seja, quase 50 milhões de somas no pior caso, quando o par certo está no fim da lista.
Complexidade de espaço: O(1). O código usa só as variáveis n, i e j, e essa memória não muda com o tamanho da lista.
O custo está no laço interno. Para cada número, ele procura o complemento, ou seja, o valor que falta para chegar ao alvo (target - nums[i]), olhando o resto da lista de novo. As próximas versões tornam essa busca mais barata.
Solução 2: ordenação e dois ponteiros
Em uma lista ordenada, a busca pelo par fica mais simples. Um ponteiro começa no menor número e outro no maior. Se a soma dos dois é menor que o alvo, o ponteiro da esquerda avança para um número maior. Se a soma é maior, o ponteiro da direita recua para um número menor. Se é igual, o par foi encontrado. Cada passo descarta um número, então os ponteiros se encontram em no máximo n - 1 passos.
O problema pede os índices originais, e a ordenação muda as posições. Por isso, cada valor é guardado junto com o seu índice em uma tupla (valor, indice) antes de ordenar.
def two_sum_ordenacao(nums: list[int], target: int) -> list[int]:
    # Guarda o índice original junto com cada valor,
    # porque a ordenação muda as posições
    pares = sorted((valor, indice) for indice, valor in enumerate(nums))
    esquerda, direita = 0, len(pares) - 1
    while esquerda < direita:
        soma = pares[esquerda][0] + pares[direita][0]
        if soma == target:
            return [pares[esquerda][1], pares[direita][1]]
        if soma < target:
            # Soma pequena: avança a esquerda para um valor maior
            esquerda += 1
        else:
            # Soma grande: recua a direita para um valor menor
            direita -= 1
    return []
Por exemplo, em nums = [3, 2, 4] com target = 6, a lista ordenada fica [(2, 1), (3, 0), (4, 2)]. A primeira soma já é 2 + 4 = 6, e a resposta sai com os índices originais, [1, 2].
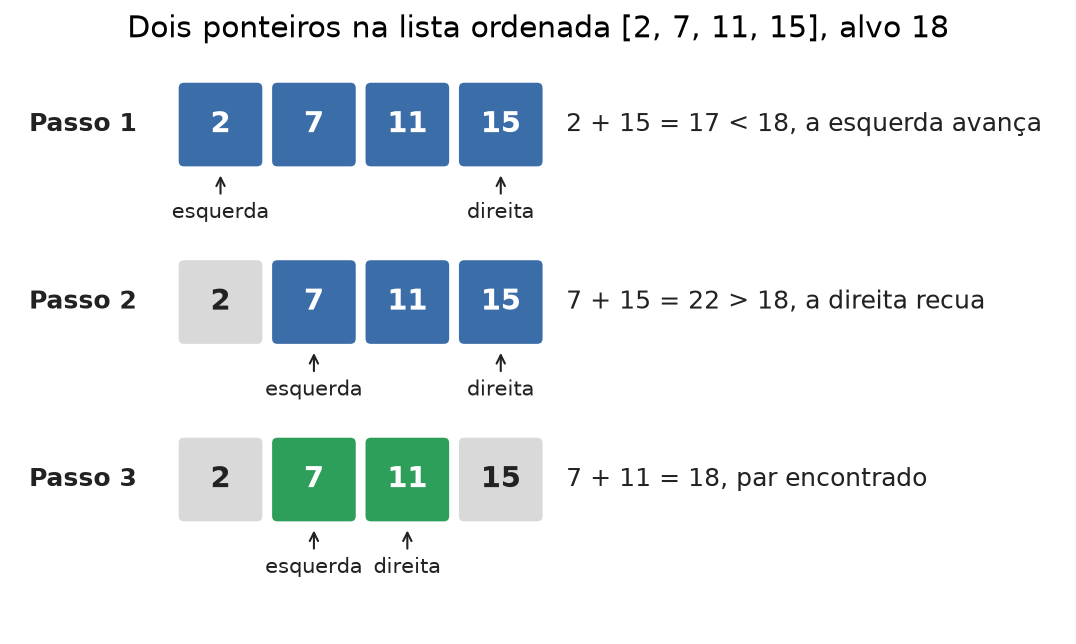
Figura 3. Dois ponteiros na lista ordenada [2, 7, 11, 15] com alvo 18. A cada passo, um número é descartado até a soma 7 + 11 = 18. Elaborado para este post.
Complexidade de tempo: O(n log n). A ordenação domina o custo. A função sorted do Python usa o algoritmo Timsort, que faz O(n log n) comparações. Os dois ponteiros somam só O(n). Com 10.000 números, n × log₂ n dá cerca de 133 mil operações, contra quase 50 milhões da força bruta.
Complexidade de espaço: O(n). A lista pares é uma cópia da entrada com os índices.
Esta versão já é muito mais rápida, mas ainda paga pela ordenação. O problema não precisa da lista ordenada, só precisa saber se o complemento existe e em qual posição está. Um hash map responde a isso sem ordenar a lista.
Solução 3: hash map em duas passadas
Em Python, o hash map é o dicionário (dict). Ele guarda pares de chave e valor e encontra uma chave em tempo O(1) no caso médio, ou seja, o tempo da busca não depende do tamanho do dicionário. A tabela de complexidade da wiki do Python registra esse custo para as operações k in d, leitura e escrita.
A primeira passada percorre a lista e guarda cada valor como chave, com o seu índice como valor. A segunda passada percorre a lista de novo e, para cada número, verifica se o complemento está no dicionário.
def two_sum_hash_duas_passadas(nums: list[int], target: int) -> list[int]:
    # 1ª passada: guarda o índice de cada valor no dicionário
    # Se um valor se repete, fica o último índice
    posicao = {}
    for indice, valor in enumerate(nums):
        posicao[valor] = indice
    # 2ª passada: procura o complemento de cada número
    for indice, valor in enumerate(nums):
        complemento = target - valor
        # A segunda condição impede usar o mesmo elemento duas vezes
        if complemento in posicao and posicao[complemento] != indice:
            return [indice, posicao[complemento]]
    return []
A condição posicao[complemento] != indice resolve o exemplo 2. Em [3, 2, 4] com alvo 6, o complemento do 3 é o próprio 3. Sem essa condição, a função devolveria [0, 0]. Com valores repetidos, como em [3, 3], o dicionário fica com o último índice do 3, que é 1. Na segunda passada, o 3 da posição 0 encontra o complemento na posição 1, e a resposta é [0, 1].
Complexidade de tempo: O(n). São duas passadas pela lista, ou seja, cerca de 2n operações, cada uma com custo O(1) no caso médio. Na notação Big O, a constante 2 é descartada. A mesma wiki registra que, no pior caso, quando muitas chaves caem na mesma posição da tabela, uma busca no dicionário pode custar O(n). A análise deste post usa o caso médio, que é o padrão nesse tipo de problema.
Complexidade de espaço: O(n). O dicionário pode guardar até n chaves.
A segunda passada repete trabalho. Quando a função chega a um número, todos os anteriores já passaram pelo laço. Dá para procurar o complemento e preencher o dicionário no mesmo laço.
Solução 4: hash map em uma passada
Nesta versão, o dicionário guarda só os números já vistos. Para cada número, a função calcula o complemento e procura no dicionário. Se encontrar, o par está completo, porque o complemento apareceu antes, em outra posição. Se não encontrar, o número atual entra no dicionário e o laço segue.
def two_sum_hash_uma_passada(nums: list[int], target: int) -> list[int]:
    # Números já vistos, no formato valor -> índice
    vistos = {}
    for indice, valor in enumerate(nums):
        complemento = target - valor
        # Se o complemento já apareceu antes, o par está completo
        if complemento in vistos:
            return [vistos[complemento], indice]
        # O número atual só entra no dicionário depois da busca
        vistos[valor] = indice
    return []
Para nums = [3, 2, 4] e target = 6, a execução tem três passos.
| Passo | Índice | Valor | Complemento | vistos antes da busca | Resultado |
|---|---|---|---|---|---|
| 1 | 0 | 3 | 3 | {} | Não encontra, guarda o 3 |
| 2 | 1 | 2 | 4 | {3: 0} | Não encontra, guarda o 2 |
| 3 | 2 | 4 | 2 | {3: 0, 2: 1} | Encontra o 2 no índice 1 e devolve [1, 2] |
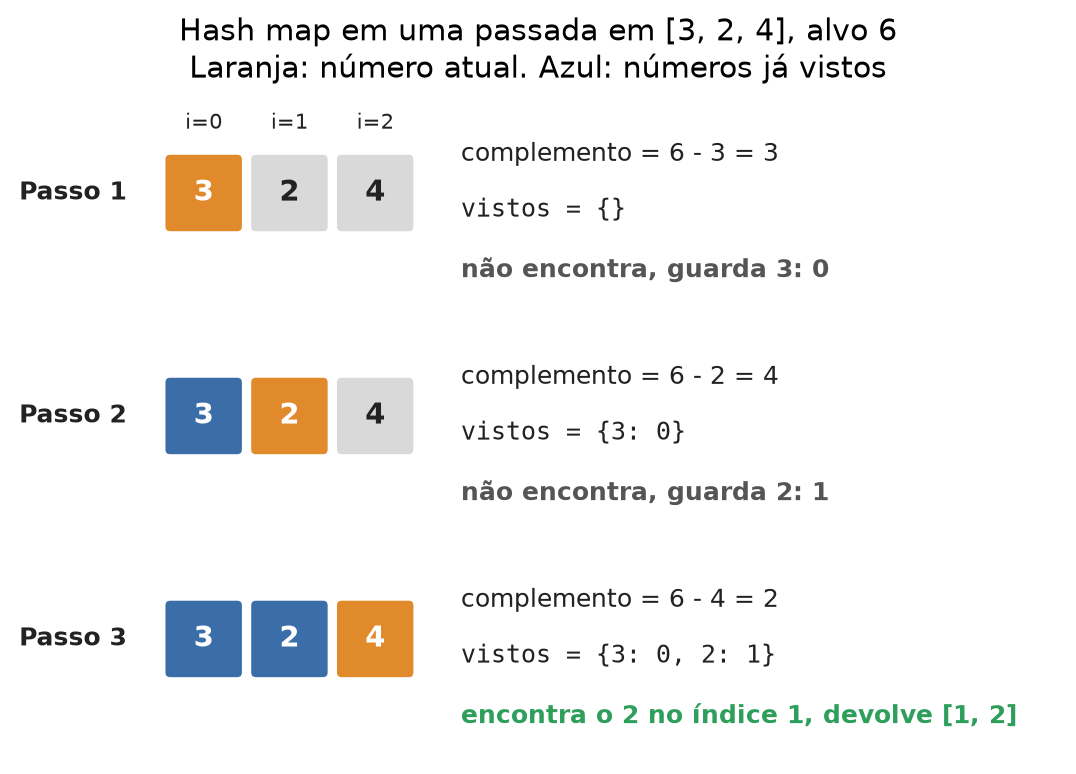
Figura 4. Hash map em uma passada para [3, 2, 4] com alvo 6. O complemento é buscado em vistos antes de o número atual entrar no dicionário. Elaborado para este post.
Como a busca acontece antes da inserção, um número nunca encontra a si mesmo. Por isso, esta versão não precisa da condição != da solução 3. Com [3, 3], o primeiro 3 entra no dicionário e o segundo encontra o primeiro, com resposta [0, 1].
Complexidade de tempo: O(n). No pior caso, a função percorre a lista uma vez. Além disso, ela pode parar antes do fim. Em [2, 7, 11, 15], por exemplo, a resposta sai no segundo número.
Complexidade de espaço: O(n). No pior caso, o dicionário guarda n - 1 números antes de achar o par.
Na notação Big O, as soluções 3 e 4 empatam. A solução 4 ganha na constante: faz uma passada só, e o dicionário cresce apenas até o par aparecer.
Testes
O código das quatro funções deste post é o mesmo do script de testes, executado em Python 3.13.5. O script roda 11 casos fixos em cada solução: os 3 exemplos do enunciado e 8 casos extras, com números negativos, zeros, valores repetidos, o par no fim da lista e valores no limite de 1 bilhão. Depois, roda 500 listas aleatórias, com até 60 números entre -20 e 20. Nessas listas pode haver mais de um par válido, então o teste confere se a resposta soma o alvo com dois índices diferentes. Ao todo, foram 2.044 verificações (11 × 4 + 500 × 4), todas corretas.
Comparação
A Figura 5 mostra o tempo de cada solução no pior caso. A lista é embaralhada, e o único par válido fica nas duas últimas posições. Cada ponto é o menor tempo de 5 execuções.
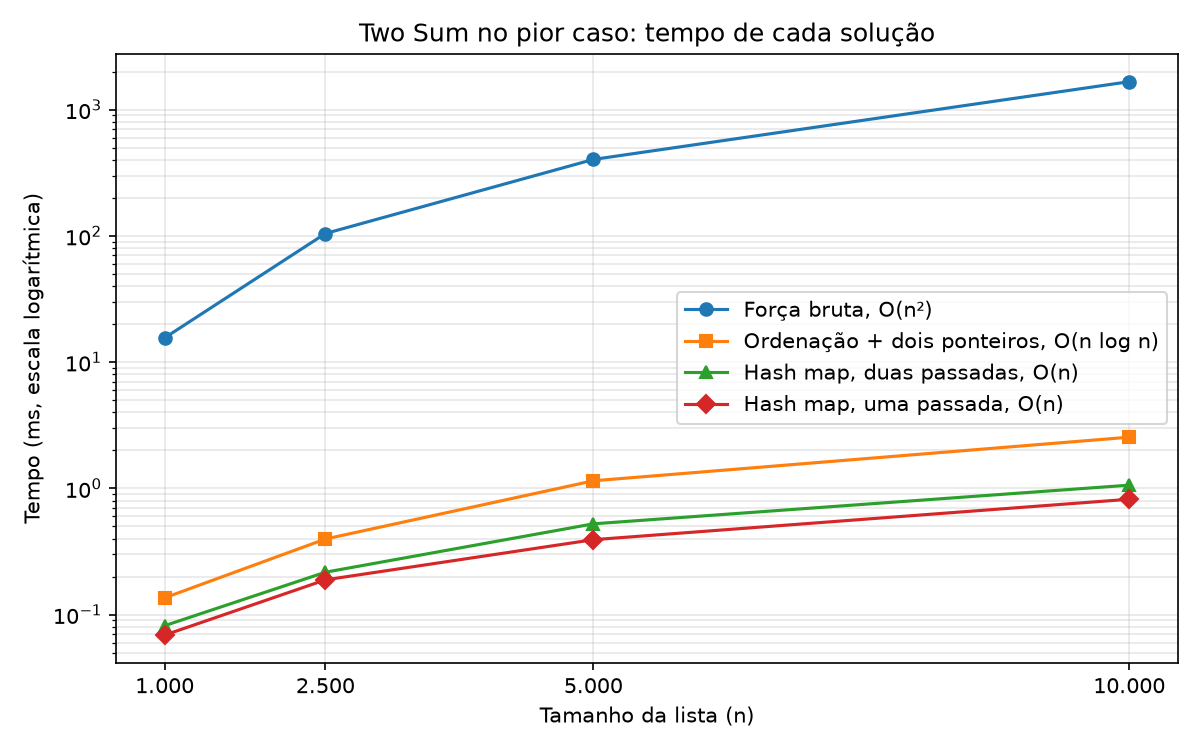
Figura 5. Tempo de cada solução do Two Sum no pior caso, em milissegundos e em escala logarítmica, para listas de 1.000, 2.500, 5.000 e 10.000 números. Gráfico elaborado para este post com o script de testes, em Python 3.13.5.
Com 10.000 números, a força bruta levou 1,66 s. A versão com ordenação levou 2,54 ms, a de duas passadas levou 1,06 ms e a de uma passada levou 0,82 ms. A força bruta foi cerca de 2 mil vezes mais lenta que a solução 4. De 5.000 para 10.000 números, o tempo da força bruta passou de 403 ms para 1.664 ms, cerca de quatro vezes mais, como prevê O(n²). O da solução 4 passou de 0,39 ms para 0,82 ms, cerca de duas vezes mais, como prevê O(n).
| Abordagem | Tempo | Espaço | Observação |
|---|---|---|---|
| Força bruta, dois laços | O(n²) | O(1) | Mais simples e sem memória extra. Levou 1,66 s com 10.000 números |
| Ordenação e dois ponteiros | O(n log n) | O(n) | Precisa guardar os índices originais antes de ordenar |
| Hash map, duas passadas | O(n) | O(n) | Precisa impedir que um número seja somado com ele mesmo |
| Hash map, uma passada | O(n) | O(n) | Busca antes de inserir e pode parar antes do fim da lista |
A solução 4 troca memória por tempo. Ela guarda até n números em um dicionário para eliminar o segundo laço da força bruta.
Próximo post da série
O próximo post da série LeetCode Easy, na sexta, 23/10, trata do problema 9, Palindrome Number. Ele pede para dizer se um número inteiro é um palíndromo, ou seja, se é lido da mesma forma da esquerda para a direita e da direita para a esquerda.
Os links da Amazon neste post são de afiliado: se você comprar por eles, recebo uma comissão, sem custo extra para você.
Para saber mais
- Problema: 1. Two Sum, LeetCode.
- Documentação: "TimeComplexity", Python Wiki. Tabela com o custo das operações de
list,setedictno CPython, no caso médio e no pior caso. - Documentação: "Dicionários", seção 5.5 do tutorial oficial do Python.
- Documentação: "Técnicas de ordenação", documentação oficial do Python, com a função
sorted, a ordenação estável e o Timsort. - Livro: Entendendo Algoritmos: um guia ilustrado para programadores e outros curiosos, de Aditya Y. Bhargava. 2ª edição, Novatec, 2026. ISBN 978-8575229293. Explica busca, ordenação e tabelas hash com ilustrações e exemplos em Python 3.
- Livro: Cracking the Coding Interview: 189 Programming Questions and Solutions, de Gayle Laakmann McDowell. 6ª edição, CareerCup, 2015. ISBN 978-0984782857. Em inglês, com 189 questões de entrevista resolvidas e uma seção sobre notação Big O.