- Published on
LeetCode Easy 14: Longest Common Prefix em Python
- Authors
- Name
- Michel Fernandes
- @michelpf
Neste post, o problema 14 do LeetCode, Longest Common Prefix, é resolvido em Python de quatro formas. O post faz parte da série LeetCode Easy, que traz toda sexta um problema de nível fácil (Easy), da solução mais simples até a mais eficiente. O post anterior tratou do problema 13, o Roman to Integer. Cada versão tem código comentado e testado, com a análise de complexidade em notação Big O. Os posts ficam reunidos na tag leetcode-easy.
O problema
O Longest Common Prefix recebe uma lista de palavras strs e pede o maior prefixo comum a todas elas. Prefixo é o começo da palavra. Em "flower", "flow" e "flight", as três começam com "fl", e a resposta é "fl". Se as palavras não têm nenhum começo em comum, como "dog", "racecar" e "car", a resposta é o texto vazio "".
O enunciado garante que a lista tem de 1 a 200 palavras, que cada palavra tem de 0 a 200 letras e que só aparecem letras minúsculas do inglês.
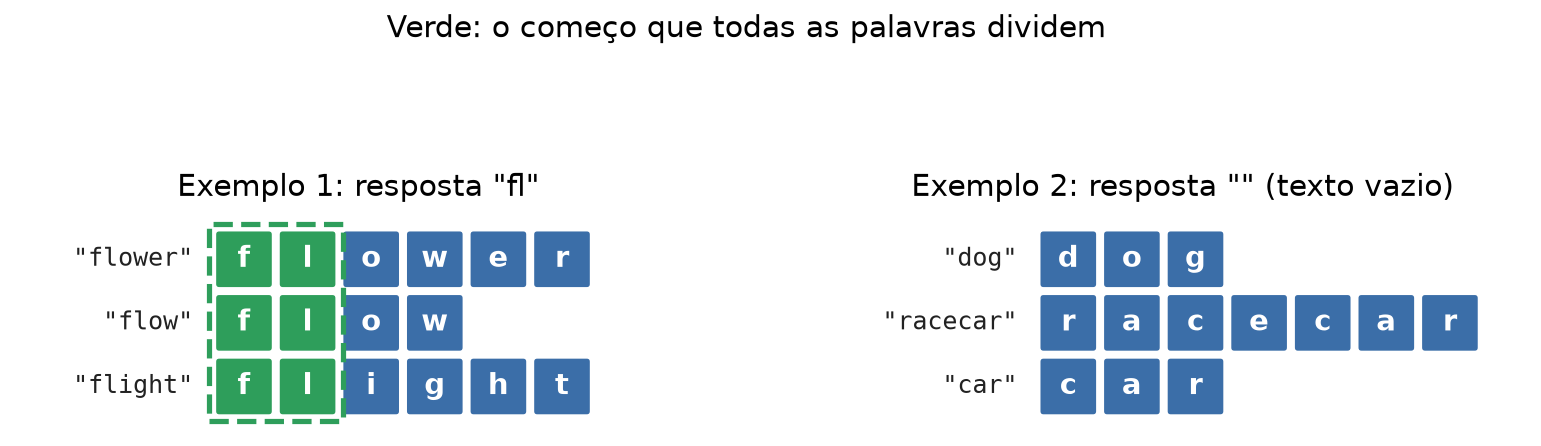
Figura 1. Os dois exemplos do enunciado. Em verde, o começo que todas as palavras dividem. Elaborado para este post.
Big O em poucas palavras
A notação Big O descreve como o custo de um algoritmo cresce quando a entrada cresce. Neste problema, a entrada tem duas medidas. A primeira é n, a quantidade de palavras. A segunda é m, o tamanho das palavras. Também aparece p, o tamanho do prefixo comum, que nunca passa de m. O(n·m) quer dizer que o trabalho cresce na proporção do número de palavras vezes o tamanho delas.
A complexidade de espaço segue a mesma ideia para a memória extra que o algoritmo usa, sem contar a resposta. O(1) quer dizer que essa memória não muda com o tamanho da entrada.
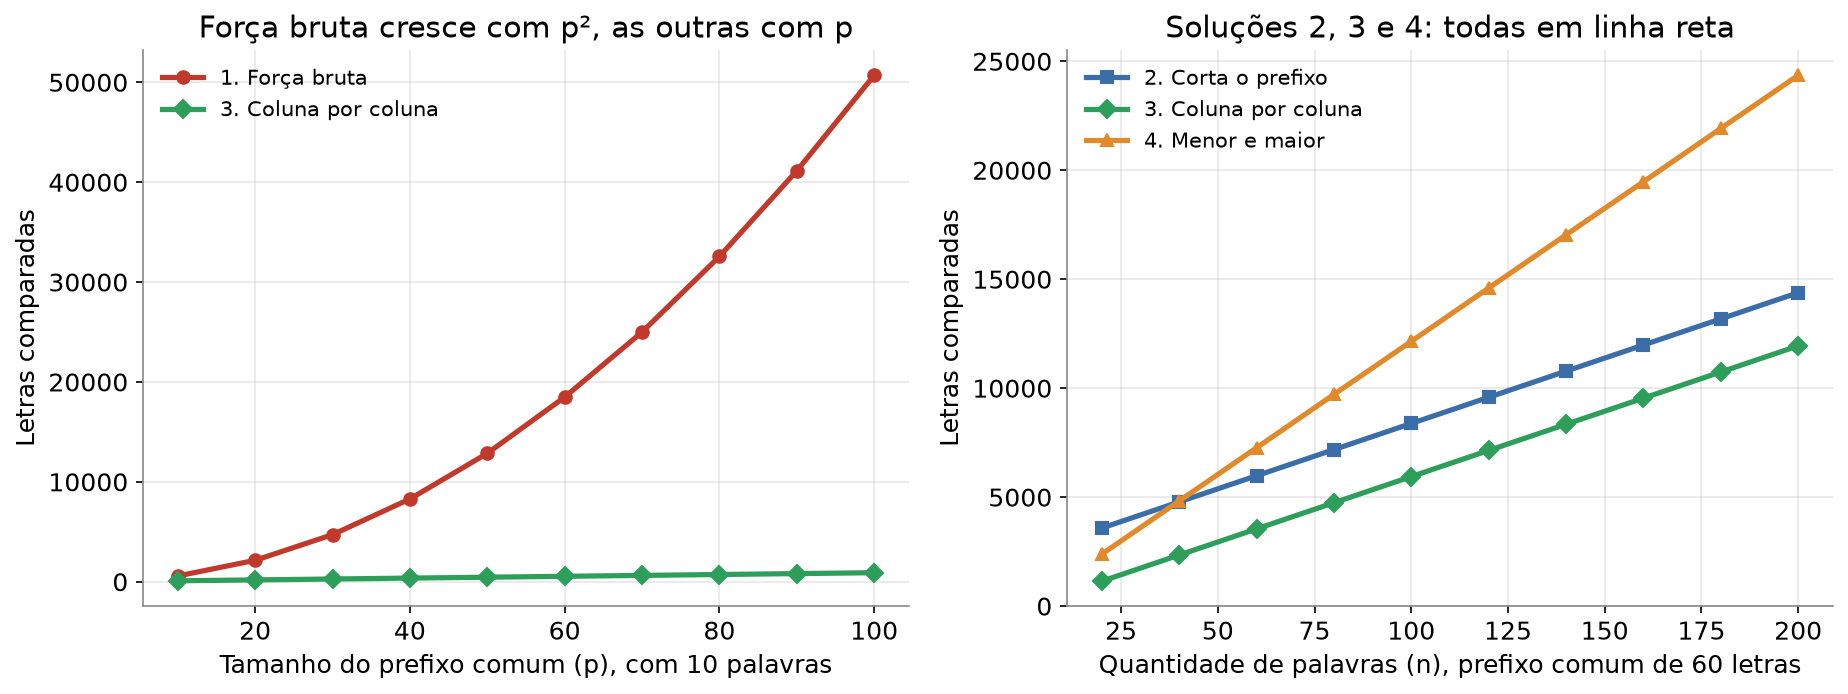
Figura 2. Letras comparadas por cada solução, contadas executando a lógica das soluções sobre listas sorteadas. À esquerda, a força bruta cresce com o quadrado do prefixo. À direita, as outras três crescem em linha reta com a quantidade de palavras. Elaborado para este post.
Solução 1: força bruta
A força bruta testa prefixos cada vez maiores da primeira palavra. Começa com a primeira letra, depois as duas primeiras, e assim por diante. Para cada candidato, confere letra a letra se todas as palavras começam com ele. Quando um candidato falha, o anterior é a resposta.
def prefixo_forca_bruta(strs: list[str]) -> str:
    # Testa prefixos cada vez maiores da primeira palavra
    menor = min(len(p) for p in strs)
    melhor = ""
    for k in range(1, menor + 1):
        candidato = strs[0][:k]
        # Confere letra a letra se todas as palavras começam com o candidato
        if all(p[i] == candidato[i] for p in strs for i in range(k)):
            melhor = candidato
        else:
            break
    return melhor
O laço vai só até o tamanho da menor palavra, porque o prefixo comum não pode ser maior que ela. Em "flower", "flow" e "flight", o candidato "f" passa, o "fl" passa e o "flo" falha em "flight". A resposta fica "fl".
Complexidade de tempo: O(n·p²). Para conferir o candidato de k letras, a função compara k letras em cada uma das n palavras. Como k vai de 1 até p, as primeiras letras são comparadas de novo a cada candidato. Com p = 100 e 10 palavras, foram cerca de 50 mil comparações, como mostra a Figura 2.
Complexidade de espaço: O(m). Cada candidato é uma cópia de até m letras da primeira palavra.
O desperdício está em conferir o começo das palavras várias vezes. As próximas versões olham cada letra uma vez só.
Solução 2: cortar o prefixo
A segunda solução começa supondo que a primeira palavra inteira é o prefixo comum. Depois, passa pelas outras palavras, uma de cada vez. Enquanto a palavra não começa com o prefixo, a última letra do prefixo é cortada. Ao fim da lista, sobra só o que todas dividem.
def prefixo_horizontal(strs: list[str]) -> str:
    # Começa com a primeira palavra inteira como prefixo
    prefixo = strs[0]
    for palavra in strs[1:]:
        # Corta a última letra até a palavra começar com o prefixo
        while not palavra.startswith(prefixo):
            prefixo = prefixo[:-1]
        if not prefixo:
            break  # nada em comum, não adianta continuar
    return prefixo
O método str.startswith diz se um texto começa com outro. Quando o prefixo fica vazio, todo texto começa com ele, e o laço while para sozinho. O break só evita olhar o resto da lista.
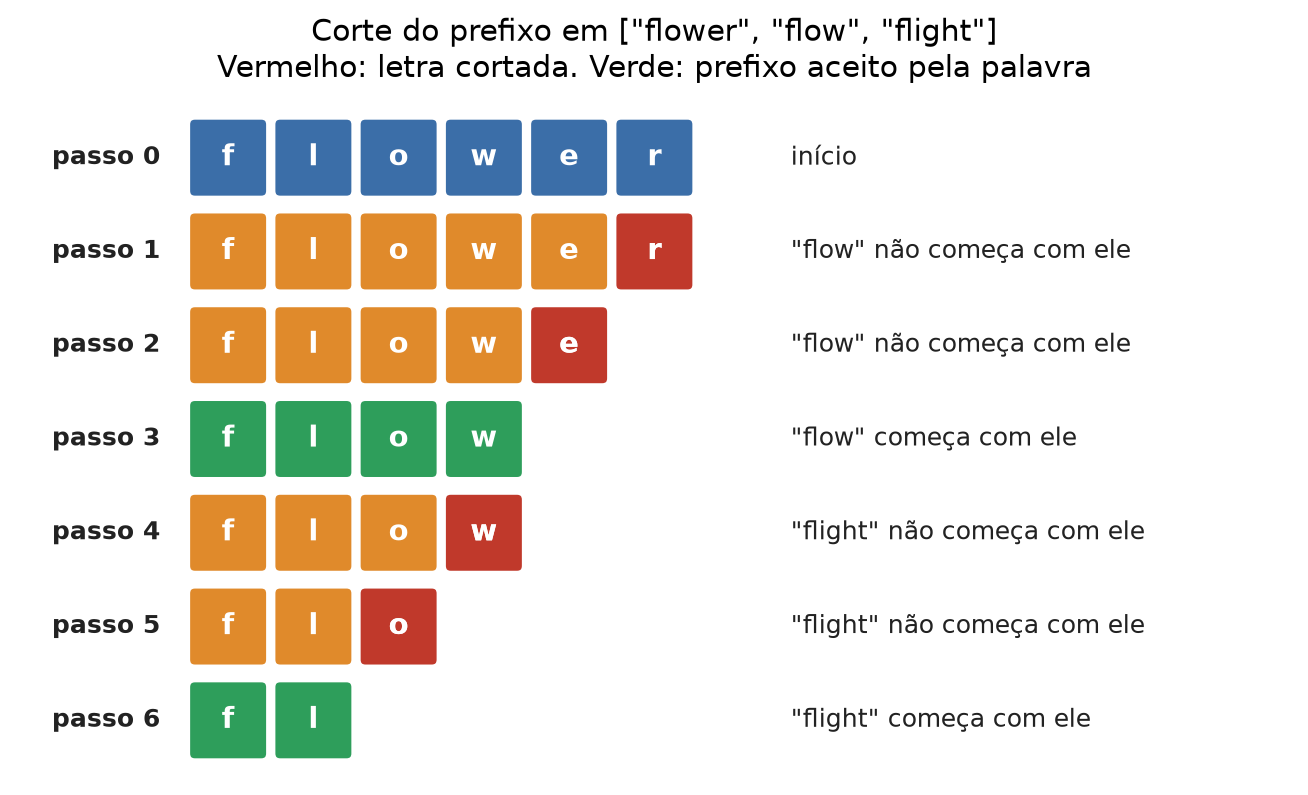
Figura 3. Corte do prefixo em "flower", "flow" e "flight". O prefixo perde quatro letras e termina em "fl". Elaborado para este post.
Complexidade de tempo: O(n·m + m²). Cada palavra é comparada com o prefixo pelo menos uma vez, com até m letras por comparação. Além disso, o prefixo perde no máximo m letras ao todo, e cada corte custa uma nova comparação de até m letras.
Complexidade de espaço: O(m). Cada corte cria uma cópia nova do prefixo.
A solução pode gastar muito trabalho na primeira palavra quando ela é longa e o prefixo comum é curto. A próxima versão para na primeira diferença, sem cortes.
Solução 3: coluna por coluna
A terceira solução lê as palavras como se estivessem empilhadas, uma embaixo da outra. Ela olha a coluna 0 de todas as palavras, depois a coluna 1, e assim por diante. Na primeira coluna em que uma letra é diferente, ou em que uma palavra acaba, o prefixo termina.
def prefixo_vertical(strs: list[str]) -> str:
    primeira = strs[0]
    # Olha a coluna i de todas as palavras ao mesmo tempo
    for i in range(len(primeira)):
        letra = primeira[i]
        for palavra in strs[1:]:
            # Palavra acabou ou letra diferente: o prefixo termina aqui
            if i == len(palavra) or palavra[i] != letra:
                return primeira[:i]
    return primeira
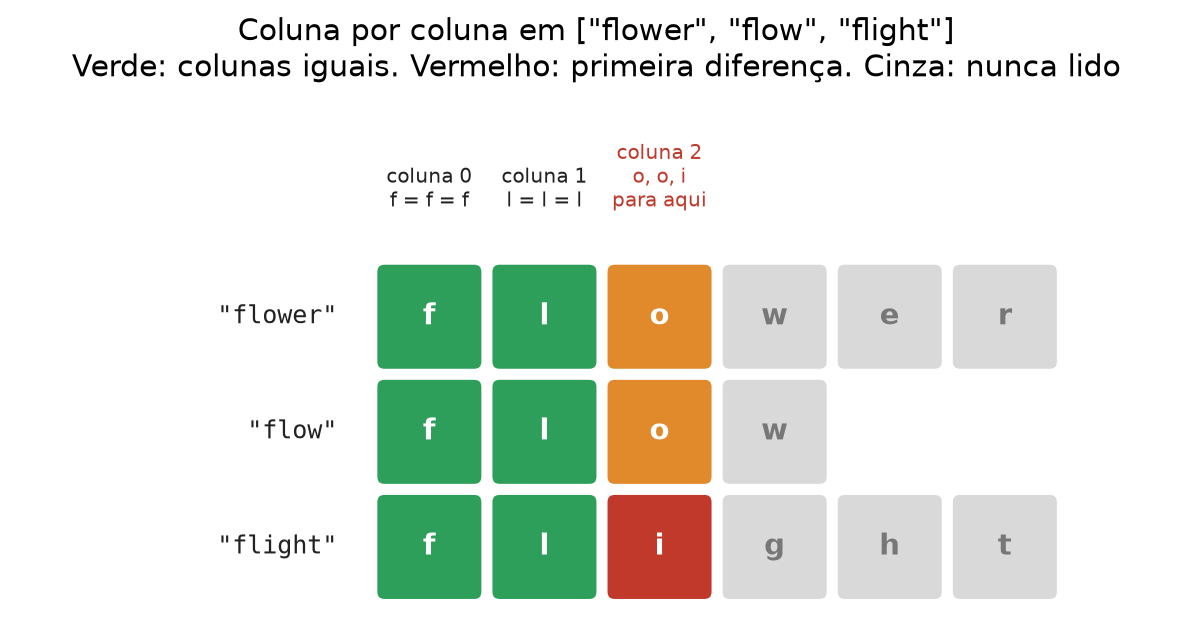
Figura 4. Coluna por coluna em "flower", "flow" e "flight". A leitura para na coluna 2, e as letras em cinza nunca são lidas. Elaborado para este post.
Complexidade de tempo: O(n·p), que no pior caso é O(n·m). A função compara cada palavra com a primeira só nas p colunas do prefixo, mais a coluna em que encontra a diferença.
Complexidade de espaço: O(1). Fora a resposta, o código guarda só a posição e a letra da coluna.
Na contagem de letras, esta é a solução que menos compara, como mostra a Figura 2. Mesmo assim, cada comparação passa pelo laço do Python, uma letra por vez. A próxima versão deixa quase todo o trabalho para funções internas do Python.
Solução 4: a menor e a maior palavra
A quarta solução usa a ordem alfabética. Ao colocar as palavras em ordem, a primeira e a última são as que mais diferem no começo. Qualquer letra que as duas dividem no início, as palavras do meio também dividem, porque estão entre elas na ordem. Por isso basta comparar a menor e a maior palavra, que o Python acha com min e max.
def prefixo_min_max(strs: list[str]) -> str:
    # Em ordem alfabética, a menor e a maior palavra são as mais diferentes
    menor, maior = min(strs), max(strs)
    # O que as duas têm em comum, todas têm
    for i, letra in enumerate(menor):
        if letra != maior[i]:
            return menor[:i]
    return menor
O laço percorre a menor palavra e não passa do fim da maior. Se a menor palavra é prefixo da maior, como "a" e "ab", o laço termina sem achar diferença e a resposta é a própria menor palavra.
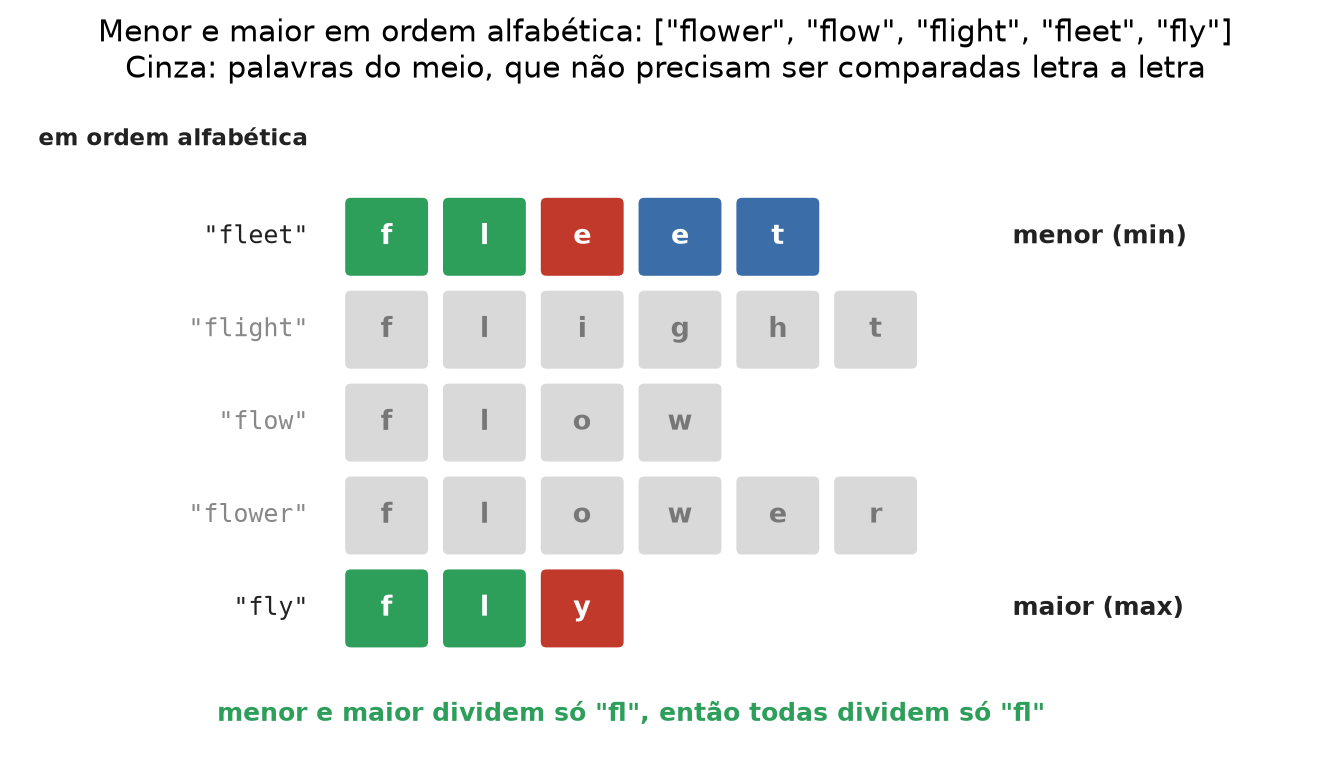
Figura 5. Menor e maior palavra em uma lista de cinco. Só "fleet" e "fly" são comparadas letra a letra no fim, e o prefixo delas vale para a lista toda. Elaborado para este post.
Complexidade de tempo: O(n·m). Para achar a menor e a maior, min e max comparam cada palavra com a menor e a maior já vistas, e cada comparação de textos vai até a primeira letra diferente. Depois, o laço final compara no máximo m letras.
Complexidade de espaço: O(1). Fora a resposta, o código guarda só referências para duas palavras da lista.
Na contagem de letras, esta solução compara cerca do dobro da solução 3, porque min e max passam pela lista cada um uma vez. A diferença está em quem faz o trabalho. As comparações de textos dentro de min e max rodam em C, a linguagem em que o Python é escrito, e não no laço do Python.
Testes
O código das quatro funções deste post é o mesmo do script de testes, executado em Python 3.13.5. O script roda 14 casos fixos em cada solução: os 2 exemplos do enunciado e 12 casos extras, como uma palavra só, palavra vazia, palavras iguais, uma palavra que é prefixo da outra e 200 palavras de 200 letras. Depois, roda 5.000 listas sorteadas com as letras a, b e c, para forçar começos em comum, e compara cada resposta com a função os.path.commonprefix da biblioteca padrão. Ao todo, foram 20.056 verificações (14 × 4 + 5.000 × 4), todas corretas.
Comparação
A Figura 6 mostra o tempo de cada solução pela quantidade de palavras. Para cada quantidade, de 20 a 200, foram sorteadas 10 listas de palavras com 100 letras, todas com um prefixo comum de 60 letras. Cada medida chama a função 100 vezes para cada lista (2 vezes na força bruta, que é muito mais lenta), e cada ponto é o menor tempo de 5 medidas, dividido pelo número de chamadas.
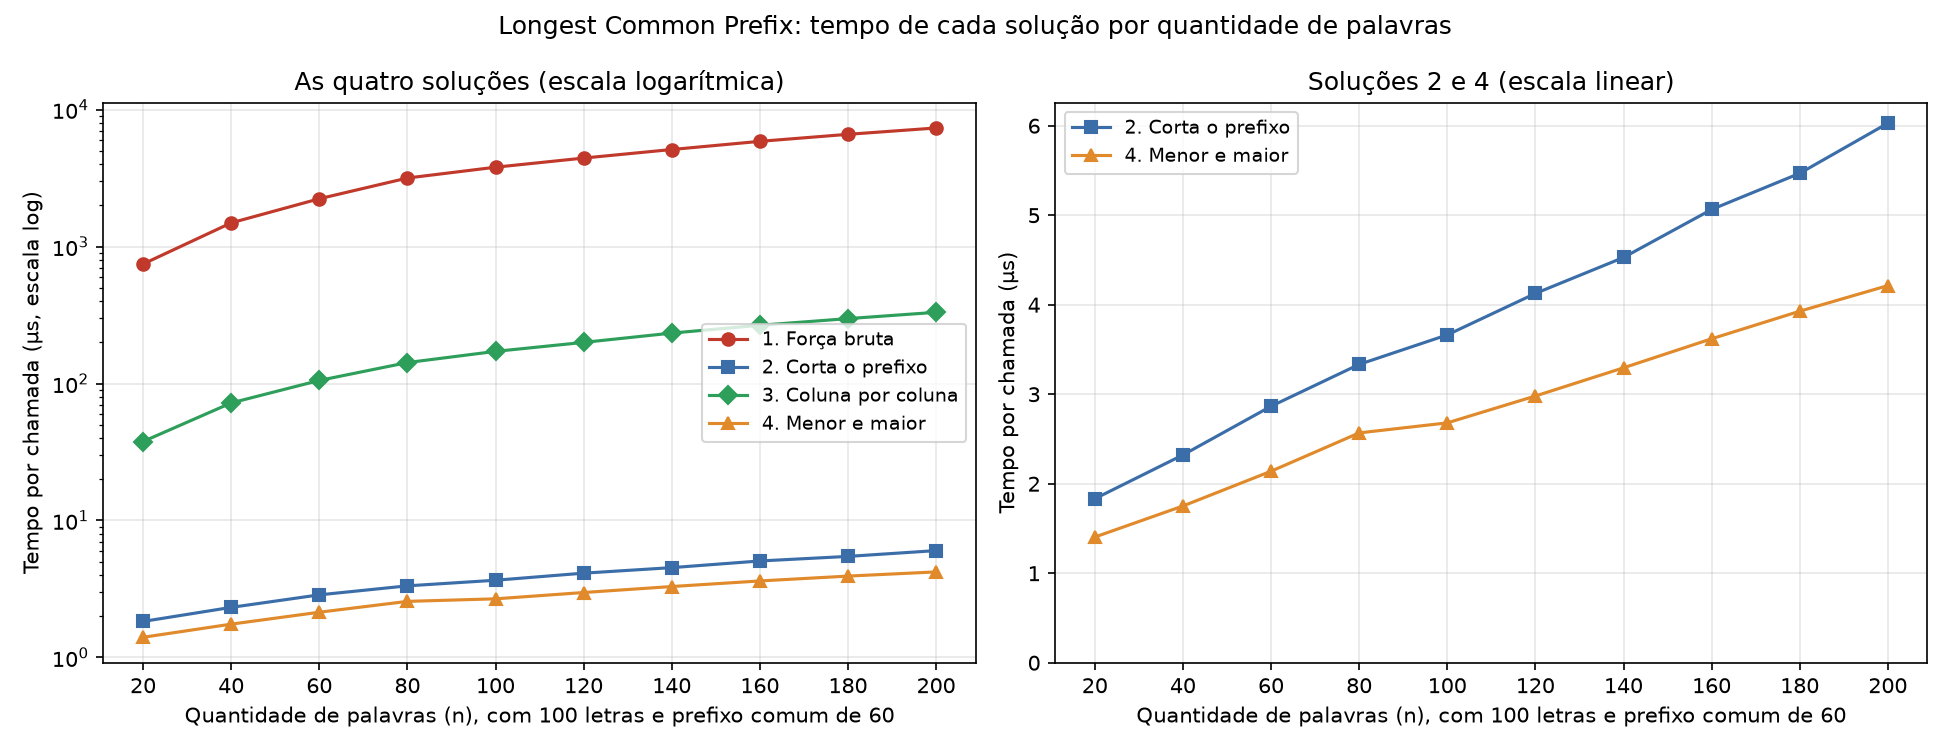
Figura 6. Tempo por chamada de cada solução do Longest Common Prefix, em microssegundos, para listas de 20 a 200 palavras de 100 letras com prefixo comum de 60. À esquerda, as quatro soluções em escala logarítmica. À direita, só as soluções 2 e 4. Gráfico elaborado para este post com o script de testes, em Python 3.13.5.
Com 200 palavras, a força bruta levou cerca de 7.337 microssegundos (7,3 ms) por chamada. A coluna por coluna levou 331 µs, o corte do prefixo levou 6,0 µs e a menor e maior levou 4,2 µs. A força bruta ficou cerca de 1.700 vezes mais lenta que a solução 4.
O resultado tem uma surpresa. A solução 3 compara menos letras que as soluções 2 e 4, mas foi mais de 50 vezes mais lenta que elas. O motivo é o mesmo dos posts do Palindrome Number e do Roman to Integer. O startswith da solução 2 e o min e o max da solução 4 são funções internas do Python, escritas em C, que comparam letras muito mais rápido que um laço em Python. Já na solução 3 cada letra comparada é uma volta do laço em Python. A solução 4 foi a mais rápida em todas as quantidades.
| Abordagem | Tempo | Espaço | Observação |
|---|---|---|---|
| Força bruta | O(n·p²) | O(m) | Confere o começo de novo a cada candidato. Levou 7,3 ms com 200 palavras |
| Corta o prefixo | O(n·m + m²) | O(m) | Comparações em C com startswith, mas cria uma cópia a cada corte |
| Coluna por coluna | O(n·p) | O(1) | Compara menos letras, mas uma por vez no laço do Python |
| Menor e maior | O(n·m) | O(1) | Compara mais letras, quase todas em C. Mais rápida em todos os tamanhos |
A solução 4 é a mais rápida e divide com a solução 3 o menor uso de memória. A solução 3 não depende de funções internas do Python e pode ser escrita do mesmo jeito em qualquer linguagem. Por isso costuma ser a mais fácil de explicar em uma entrevista.
Próximo post da série
O próximo post da série LeetCode Easy, na sexta, 20/11, trata do problema 20, Valid Parentheses. Ele pede para conferir se um texto com parênteses, colchetes e chaves abre e fecha cada um na ordem certa.
Os links da Amazon neste post são de afiliado: se você comprar por eles, recebo uma comissão, sem custo extra para você.
Para saber mais
- Problema: 14. Longest Common Prefix, LeetCode.
- Post anterior da série: LeetCode Easy 13: Roman to Integer em Python.
- Documentação:
str.startswith, documentação oficial do Python, usada na solução 2. - Documentação:
minemax, documentação oficial do Python, usadas na solução 4. - Documentação:
os.path.commonprefix, documentação oficial do Python. Calcula o maior prefixo comum de uma lista e serviu de referência nos testes. - Documentação: módulo
timeit, documentação oficial do Python. É o módulo usado para medir os tempos deste post. - Livro: Entendendo Algoritmos: um guia ilustrado para programadores e outros curiosos, de Aditya Y. Bhargava. 2ª edição, Novatec, 2026. ISBN 978-8575229293. Explica a notação Big O com ilustrações e exemplos em Python 3.
- Livro: Cracking the Coding Interview: 189 Programming Questions and Solutions, de Gayle Laakmann McDowell. 6ª edição, CareerCup, 2015. ISBN 978-0984782857. Em inglês, com 189 questões de entrevista resolvidas e uma seção sobre notação Big O.