- Published on
Quais features uma IA usa para criar ressonâncias sintéticas no Alzheimer?
- Authors
- Name
- Michel Fernandes
- @michelpf
A pergunta do estudo
O estudo de Fallah e Herzog pergunta se uma IA generativa consegue criar fatias sintéticas de ressonância magnética cerebral, condicionadas ao diagnóstico de Alzheimer ou controle cognitivamente normal, usando uma coorte pequena do ADNI. A questão prática é relevante: muitos grupos de pesquisa têm poucas centenas de exames, classes desbalanceadas e limitações legais para compartilhar imagens médicas. Se modelos generativos produzirem imagens plausíveis sem copiar pacientes, eles podem ajudar no desenvolvimento de classificadores e na avaliação de pipelines.
O ponto central do artigo não é apenas o modelo de difusão, mas o que entra nele. Em aprendizado de máquina, features são as informações oferecidas ao algoritmo. Neste estudo, os features principais não são idade, teste cognitivo ou biomarcadores em uma tabela. São fatias 2D de MRI T1, intensidades de imagem normalizadas, posições anatômicas escolhidas previamente e um rótulo diagnóstico usado para condicionar a geração. Portanto, o pré-processamento define quase tudo que a IA poderá aprender.
A coorte ADNI e o desenho dos dados
Os dados vieram da Alzheimer’s Disease Neuroimaging Initiative, uma coorte multicêntrica criada para estudar biomarcadores clínicos, genéticos, bioquímicos e de imagem na doença de Alzheimer. A busca inicial retornou 13.988 registros de 603 sujeitos, incluindo diferentes visitas, sequências e versões de processamento.
Os autores restringiram os dados a volumes T1 em geometria nativa com correção de intensidade e depois a visitas rotineiras iniciais, como triagem, baseline e meses 6, 12 e 24. Segundo o texto, 308 sujeitos não tinham aquisição nesses códigos; esse foi o único critério de exclusão em nível de sujeito. Como esses códigos pertencem ao padrão do ADNI-1, a amostra final ficou dominada por essa fase.
Para evitar vazamento por medidas repetidas, cada participante contribuiu com apenas um volume. Quando havia mais de uma opção, o protocolo priorizou o exame com processamento mais completo: correção N3 de viés de campo, correção B1 de inhomogeneidade e correção de distorção por gradient warping. Se essa combinação não existia, eram usadas alternativas menos completas. Exames de baseline foram preferidos a follow-ups, e sequências MPR a MPR-R.
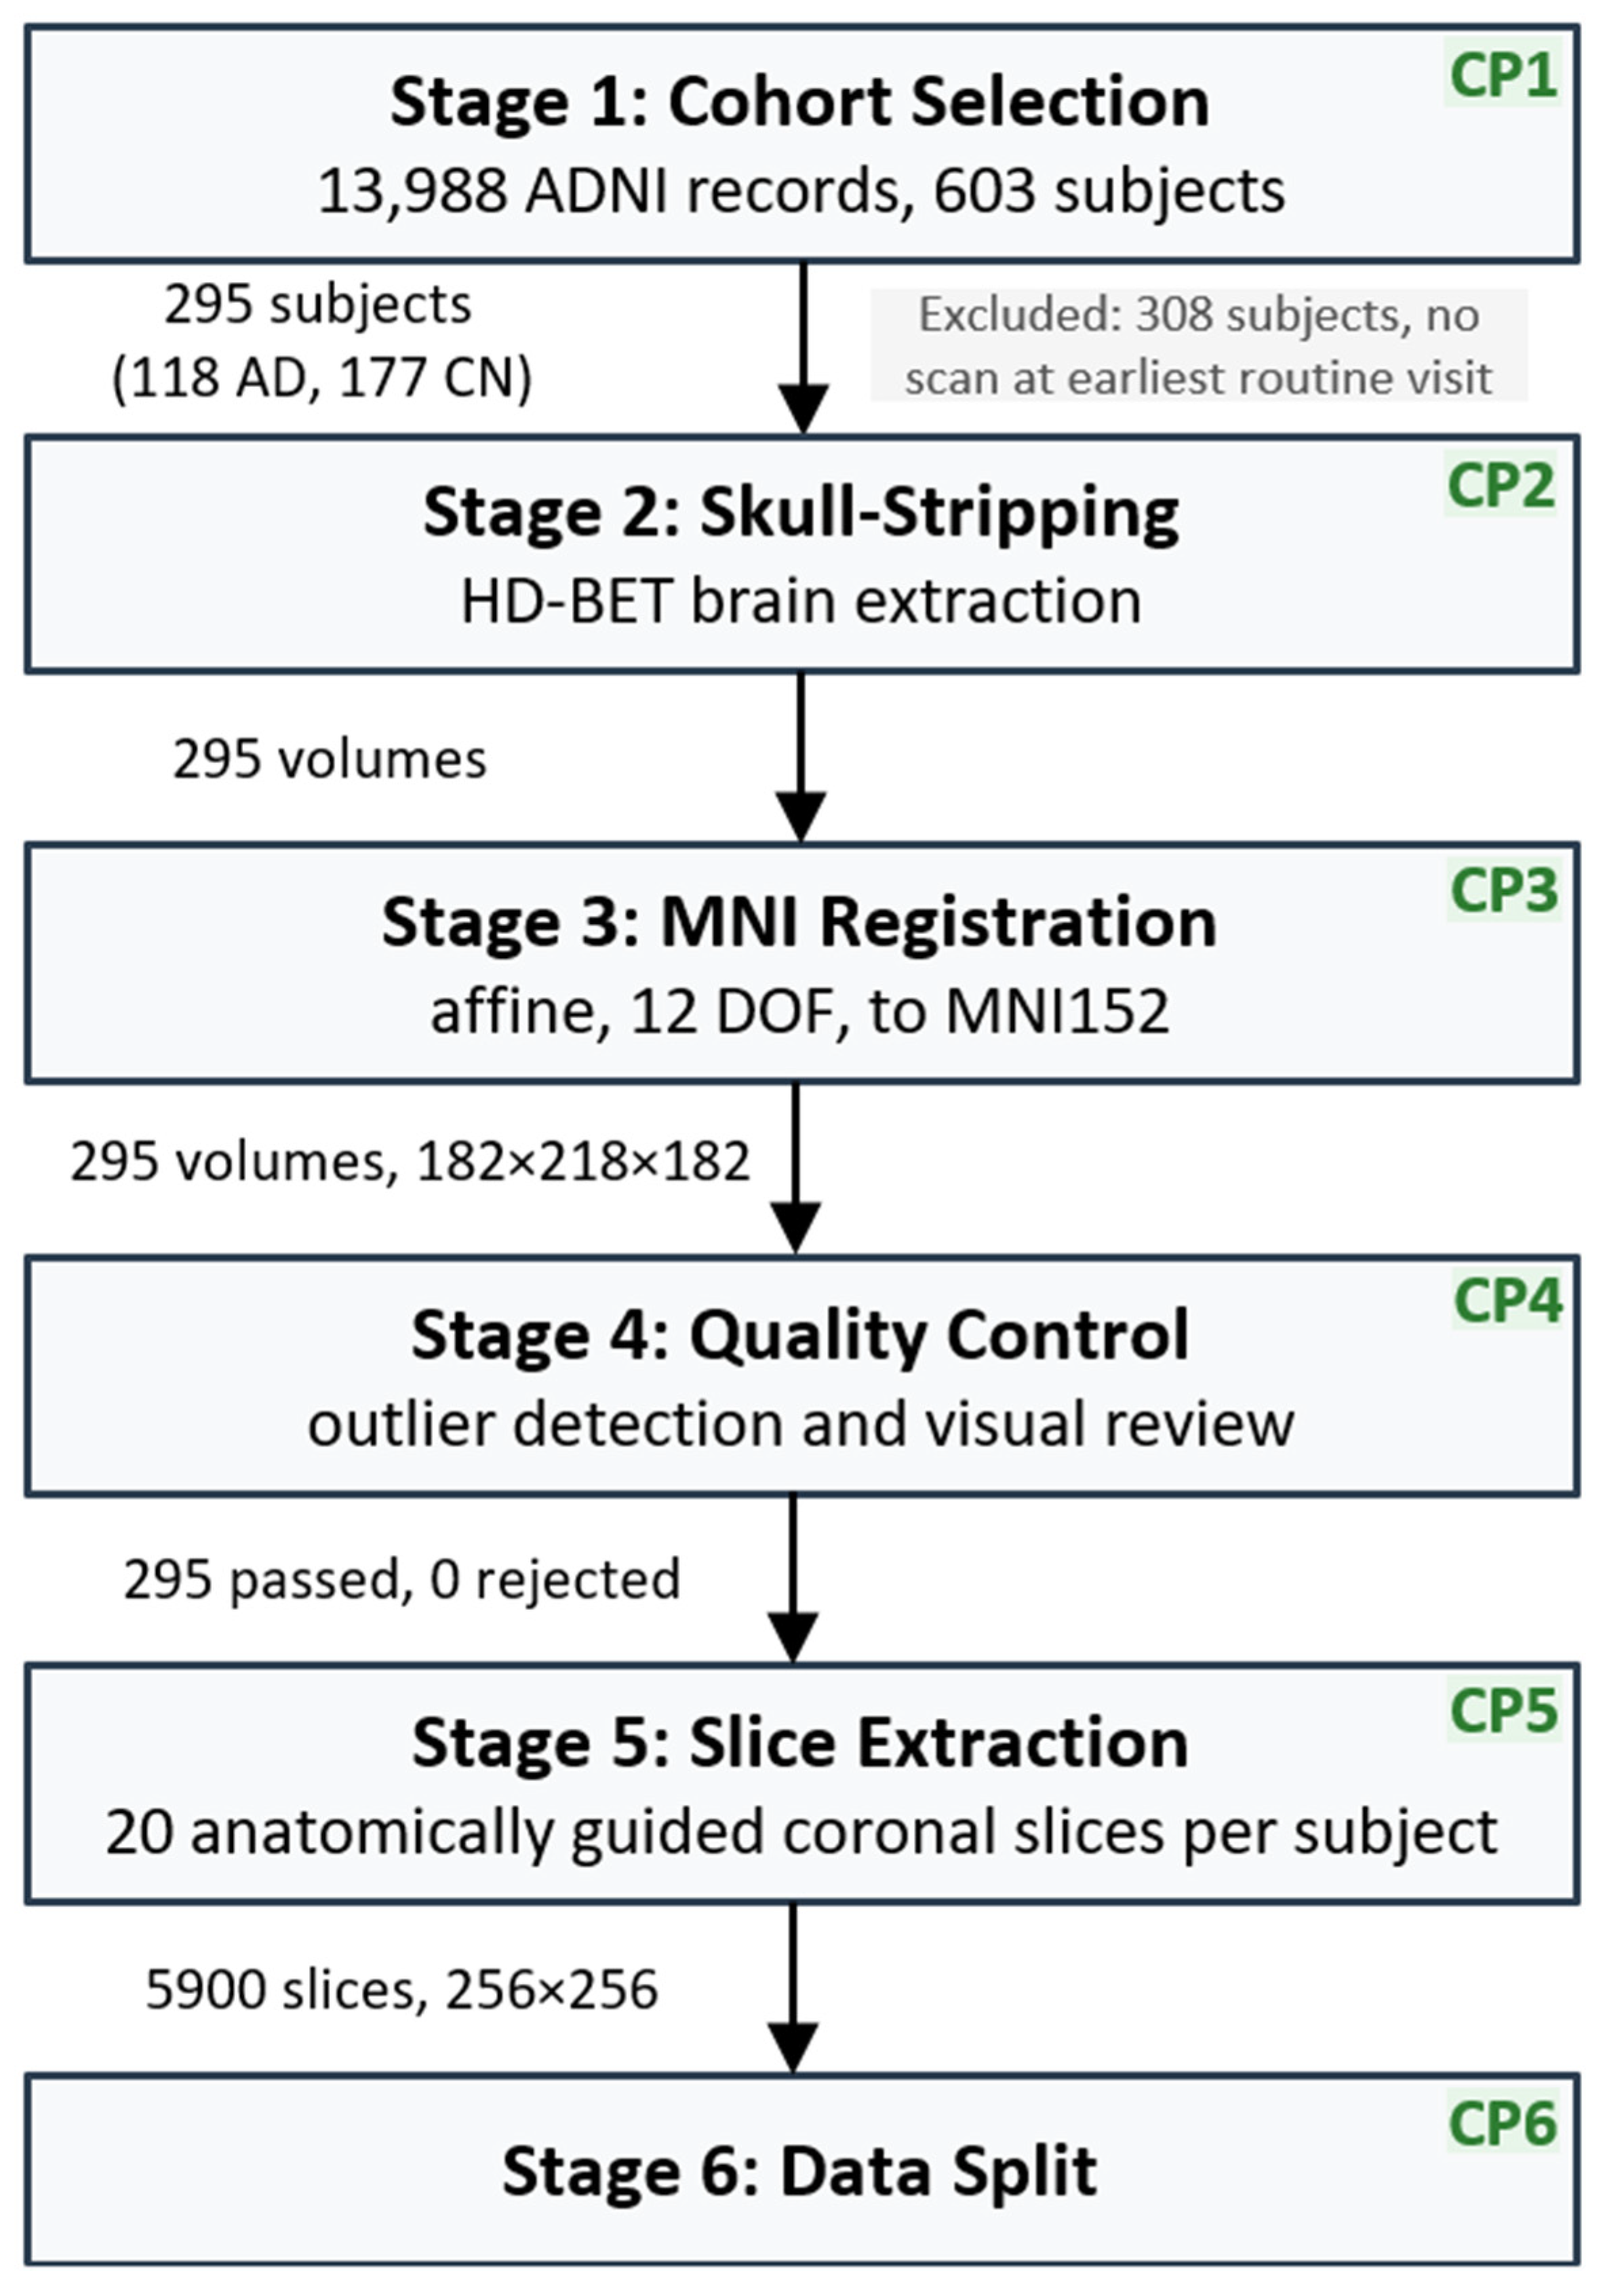
A coorte final teve 295 sujeitos: 118 com Alzheimer, 40%, e 177 cognitivamente normais, 60%. Cada sujeito gerou 20 fatias coronais, totalizando 5.900 imagens. A divisão foi feita por sujeito, não por fatia: 4.080 fatias para treino, 940 para validação e 880 para teste. Isso é essencial porque fatias do mesmo cérebro são altamente parecidas; misturá-las entre treino e teste inflaria artificialmente os resultados. A divisão também foi estratificada por diagnóstico e local de aquisição, já que sinais de scanner e fabricante podem funcionar como atalhos técnicos.
Features e variáveis de entrada: o que a IA realmente recebeu
A modalidade usada pelo modelo foi MRI estrutural T1 ponderada. O estudo não informa uso de PET, líquor, sangue, medidas volumétricas tabulares ou escores cognitivos como entrada do gerador. Variáveis como idade, sexo, MMSE, CDR, GDS, FAQ, NPI-Q, APOE, fase ADNI, fabricante, modelo de scanner e campo magnético aparecem como descrição da coorte, mas não como features do modelo generativo. Educação e raça/etnia não estavam disponíveis no export de imagens.
O feature básico do autoencoder foi uma fatia coronal 2D de 256 × 256 × 1 pixels, em formato float32, com intensidades normalizadas. Essas fatias não foram escolhidas aleatoriamente. Depois do registro espacial para o template MNI152, cada sujeito forneceu cortes em 20 coordenadas Y fixas: +58, +42, +26, +14, +2, −4, −8, −16, −20, −24, −32, −40, −45, −50, −55, −62, −70, −80, −90 e −100 mm.
A seleção usou densidade variável. Sete cortes ficaram concentrados na formação hipocampal, entre Y = +2 e −32 mm, com espaçamento de 4 a 8 mm. A justificativa foi anatômica: hipocampo e regiões temporais são importantes na progressão neuropatológica do Alzheimer. Quatro cortes adicionais cobriram cingulado posterior e precuneus, áreas associadas a alterações precoces no continuum da doença. Os nove restantes serviram como referência frontal e occipital, com espaçamento mais amplo. Assim, o conjunto de features favorece regiões consideradas relevantes antes mesmo do treinamento.
Antes da extração das fatias, cada volume foi normalizado para [0, 1] por clipping nos percentis 0,5 e 99,5 calculados por volume. O artigo informa que o percentil 99,5 variou de 47,3 a 2271,5 entre sujeitos, quase 50 vezes de diferença em intensidade bruta. Sem essa etapa, o modelo poderia aprender diferenças de escala de aquisição em vez de anatomia. Cada plano registrado media 182 × 182 voxels e foi reamostrado para 256 × 256 por interpolação cúbica spline de ordem 3, sem padding ou cropping.
No segundo estágio, a difusão não opera sobre pixels diretamente. O autoencoder VAEGAN comprime cada fatia em um latente de 32 × 32 × 8. Esse latente é outro conjunto de features: uma representação aprendida que preserva estrutura anatômica, mas reduz detalhes e custo computacional. O latente treinado teve média −3,16, desvio-padrão 5,40 e faixa de −48,7 a 34,4. Antes da difusão, foi aplicado fator 0,1852, equivalente a 1/5,40, para aproximar variância unitária.
Além da imagem, o modelo recebeu apenas a condição diagnóstica: CN ou AD. O rótulo foi codificado como token aprendido em 64 dimensões e inserido por cross-attention. Durante 15% do treino, esse rótulo foi trocado por um token incondicional, técnica chamada classifier-free guidance. Na geração, a escala de guidance foi 2,0. O artigo afirma explicitamente que não entra coordenada de fatia, rótulo anatômico ou codificação posicional. Portanto, o modelo aprende a distribuição das fatias, mas não permite pedir, na inferência, uma coordenada anatômica específica.
Pré-processamento, seleção de features e ausências
O pipeline teve seis estágios com checagens. Primeiro, seleção de um volume por sujeito. Segundo, remoção de tecido não cerebral com HD-BET, com sucesso em todos os 295 volumes e verificação de orientação RAS e voxel isotrópico de 1 mm. Terceiro, registro ao template FSL MNI152 T1 1 mm por transformação afim de 12 graus de liberdade usando ANTs e SimpleITK. Essa etapa alinha estruturas entre participantes, evitando que o mesmo pixel corresponda a anatomias diferentes.
O registro também muda o significado dos features. O texto observa que uma transformação afim de 12 graus remove volume cerebral absoluto por construção. Logo, após o registro, tamanho absoluto do cérebro não deve carregar o sinal diagnóstico. Relações proporcionais e padrões locais podem permanecer, mas o artigo não fornece uma lista de medidas morfométricas derivadas.
O quarto estágio foi controle de qualidade com seis métricas: volume cerebral, média e desvio-padrão de intensidade, contiguidade da máscara, consistência de forma e detecção de NaN ou infinito. Sete sujeitos passaram do limiar de três desvios-padrão em alguma métrica, mas foram aceitos após revisão visual. A rejeição final foi 0%.
Não houve seleção estatística de variáveis no sentido clássico, nem ranking formal de pixels, regiões ou biomarcadores. A seleção ocorreu pelo desenho anatômico das fatias e pela compressão do autoencoder. Também não houve imputação descrita para variáveis clínicas ausentes, porque elas não entraram no modelo. O texto relata n = 289 para MMSE, CDR e GDS, n = 268 para FAQ e NPI-Q e n = 294 para APOE.
Método de IA e resultados quantitativos
O modelo segue uma arquitetura de difusão latente em dois estágios. No primeiro, um AutoencoderKL da MONAI, usado como VAEGAN, reconstrói as fatias e as comprime em latentes. A perda combinou L1, LPIPS com peso 0,5, MS-SSIM com peso 0,1, regularização KL muito baixa e perda adversarial PatchGAN com peso 0,01. Na validação, o autoencoder alcançou PSNR de 38,44 dB, SSIM de 0,9861 e LPIPS de 0,0166. No teste, em 880 fatias, o PSNR médio foi 38,66 dB e o SSIM médio 0,989.
No segundo estágio, um UNet de difusão da MONAI, com cerca de 39,1 milhões de parâmetros, aprendeu a remover ruído no espaço latente condicionado ao diagnóstico. A inferência usou DDIM com 50 passos. Um detalhe técnico importante foi desativar o clip_sample padrão da biblioteca, pois o latente real variava muito além de [−1, 1]; mantê-lo ligado destruiria a distribuição latente.
Na avaliação das imagens geradas, o KID em espaço Inception v3 foi 0,030 ± 0,002. O FID bruto em 880 imagens foi 48,49, mas a extrapolação FID∞, usada para reduzir viés de amostra pequena, resultou em 43,82, com intervalo bootstrap de 43,24 a 44,40. A precisão foi 0,272 e o recall 0,417. Em termos simples, o modelo cobriu parte da distribuição real, mas muitas imagens sintéticas ainda ficaram fora do manifold real definido por essa métrica.
A ablação mais relevante manteve arquitetura, perdas, treino, sampler e avaliação fixos, mudando apenas o pré-processamento. O pipeline aprimorado melhorou o KID em 0,015, com IC 95% de −0,023 a −0,008, e aumentou a precisão em 0,069, com IC de 0,004 a 0,123. O intervalo para FID cruzou zero, então não há evidência clara de melhora nessa métrica. Um classificador treinado em imagens sintéticas e testado em imagens reais alcançou AUC em nível de sujeito de 0,779 ± 0,031, sugerindo presença de sinal diagnóstico, mas não validação clínica.
Utilidade clínica, limitações e o que não se pode concluir
A utilidade mais imediata é metodológica. O estudo mostra que, em IA generativa para MRI, features de imagem não são dados neutros: eles são produzidos por decisões de registro, normalização, seleção anatômica e compressão latente. Imagens sintéticas podem auxiliar pesquisa, comparação de pipelines e aumento de dados, especialmente onde há poucos exames reais.
Quanto à privacidade, os autores testaram memorização por vizinho mais próximo em espaço DINOv2. Nenhuma das 880 imagens geradas caiu abaixo do limiar de 0,5 para cópia quase literal; o pior caso teve razão 0,766. Eles também mostraram que comparar um treino maior com um holdout menor cria falso aumento de sinal de memorização, e por isso igualaram os tamanhos dos conjuntos de referência.
As limitações são importantes. A coorte tem 295 sujeitos, é dominada por ADNI-1 e vem de um estudo de pesquisa, não de rotina clínica comum. O modelo distingue AD de controles normais, mas não resolve previsão individual, conversão de MCI ou estadiamento. O TSTR usou validação real para seleção de checkpoint, embora sem atualização por gradiente. Na ablação, 70 sujeitos tinham imagem ADNI diferente nas fatias baseline arquivadas, e cada braço foi treinado uma única vez, sem medir variação entre treinamentos.
Também não se deve inferir causalidade. O modelo pode gerar ventrículos maiores em AD porque aprendeu uma associação visual presente nos dados, não porque prove mecanismo causal. O próprio artigo relata uma proxy de área ventricular maior em AD que em CN em uma amostra de gerações, mas sem estudo cego por especialistas. A conclusão segura é que, nesta coorte pequena, o pipeline gerou imagens sintéticas com algum realismo, algum sinal diagnóstico e sem evidência de cópia direta; ainda não prova uso clínico externo nem substituição de dados reais.
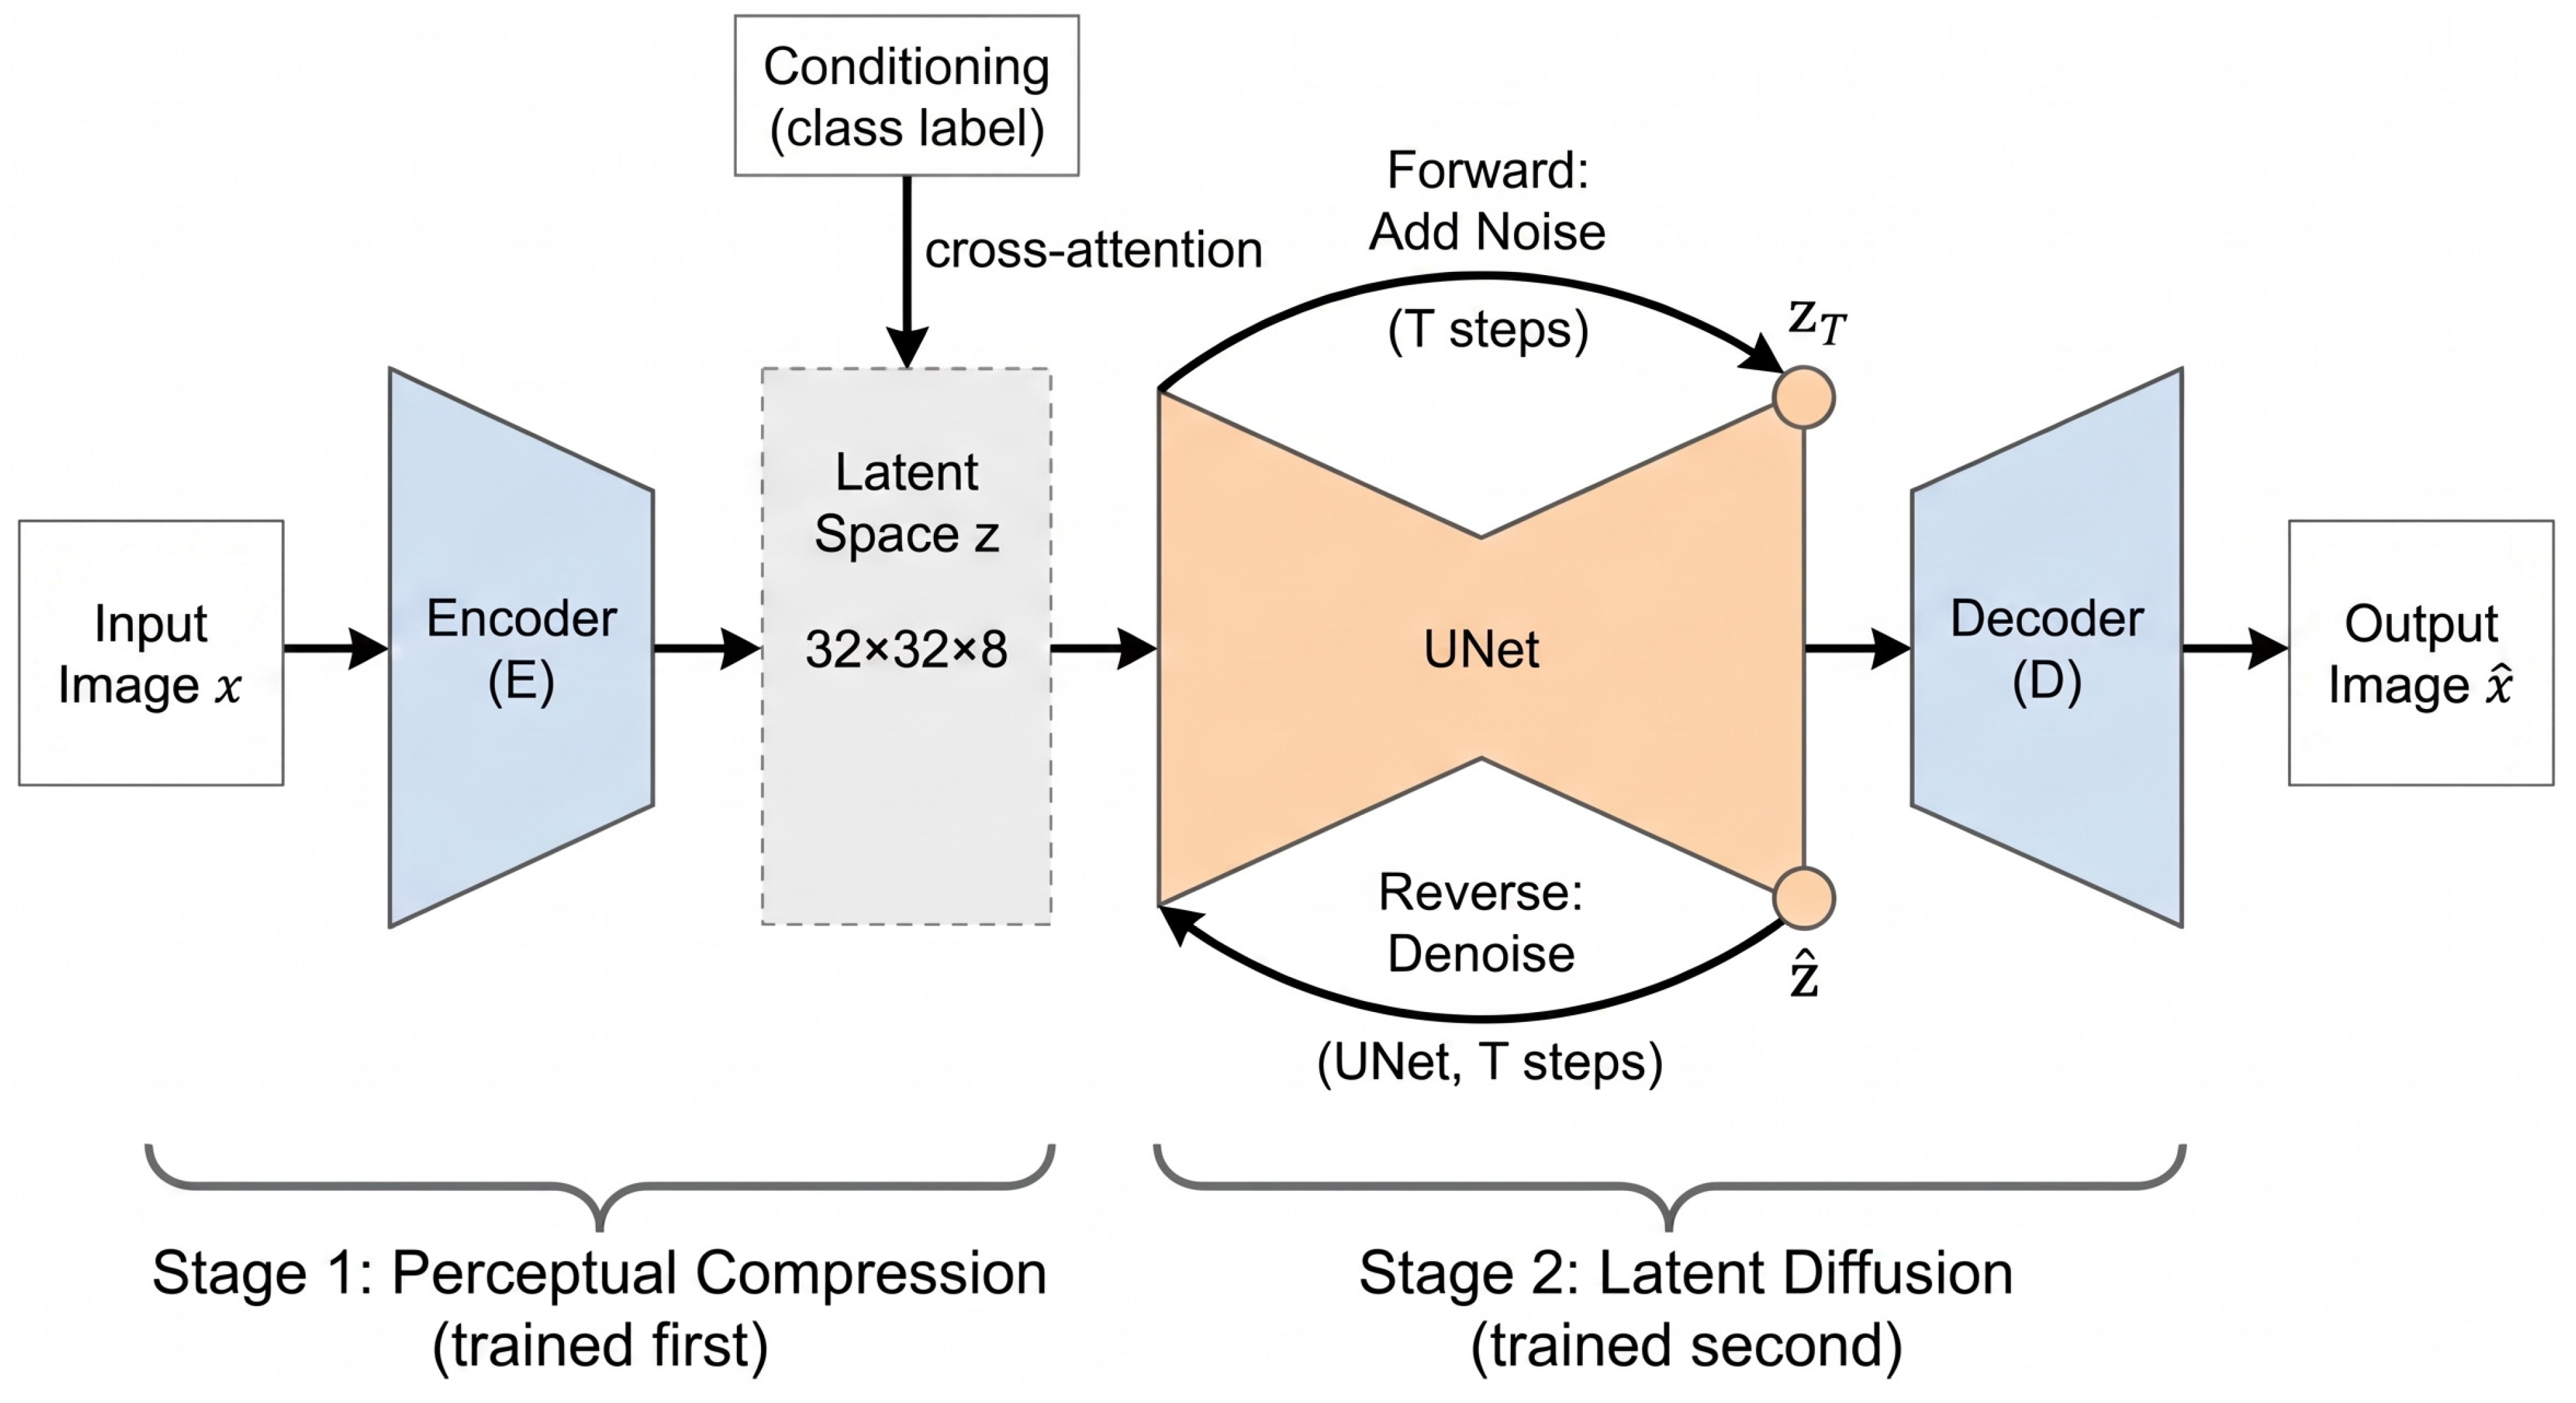
Two-stage conditional latent diffusion pipeline. In Stage 1 (perceptual compression, trained first), an encoder E maps an input image x to a compact latent representation z of size 32 × 32 × 8. In Stage 2 (latent diffusion, trained second), a forward process adds noise to the latent over T steps to reach zT, and a UNet learns the reverse process, denoising over T steps to recover z^ while conditioning on the diagnostic class label through cross-attention. A decoder D reconstructs the denoised latent into the output image x^. The dashed box marks the shared latent space linking the two stages.
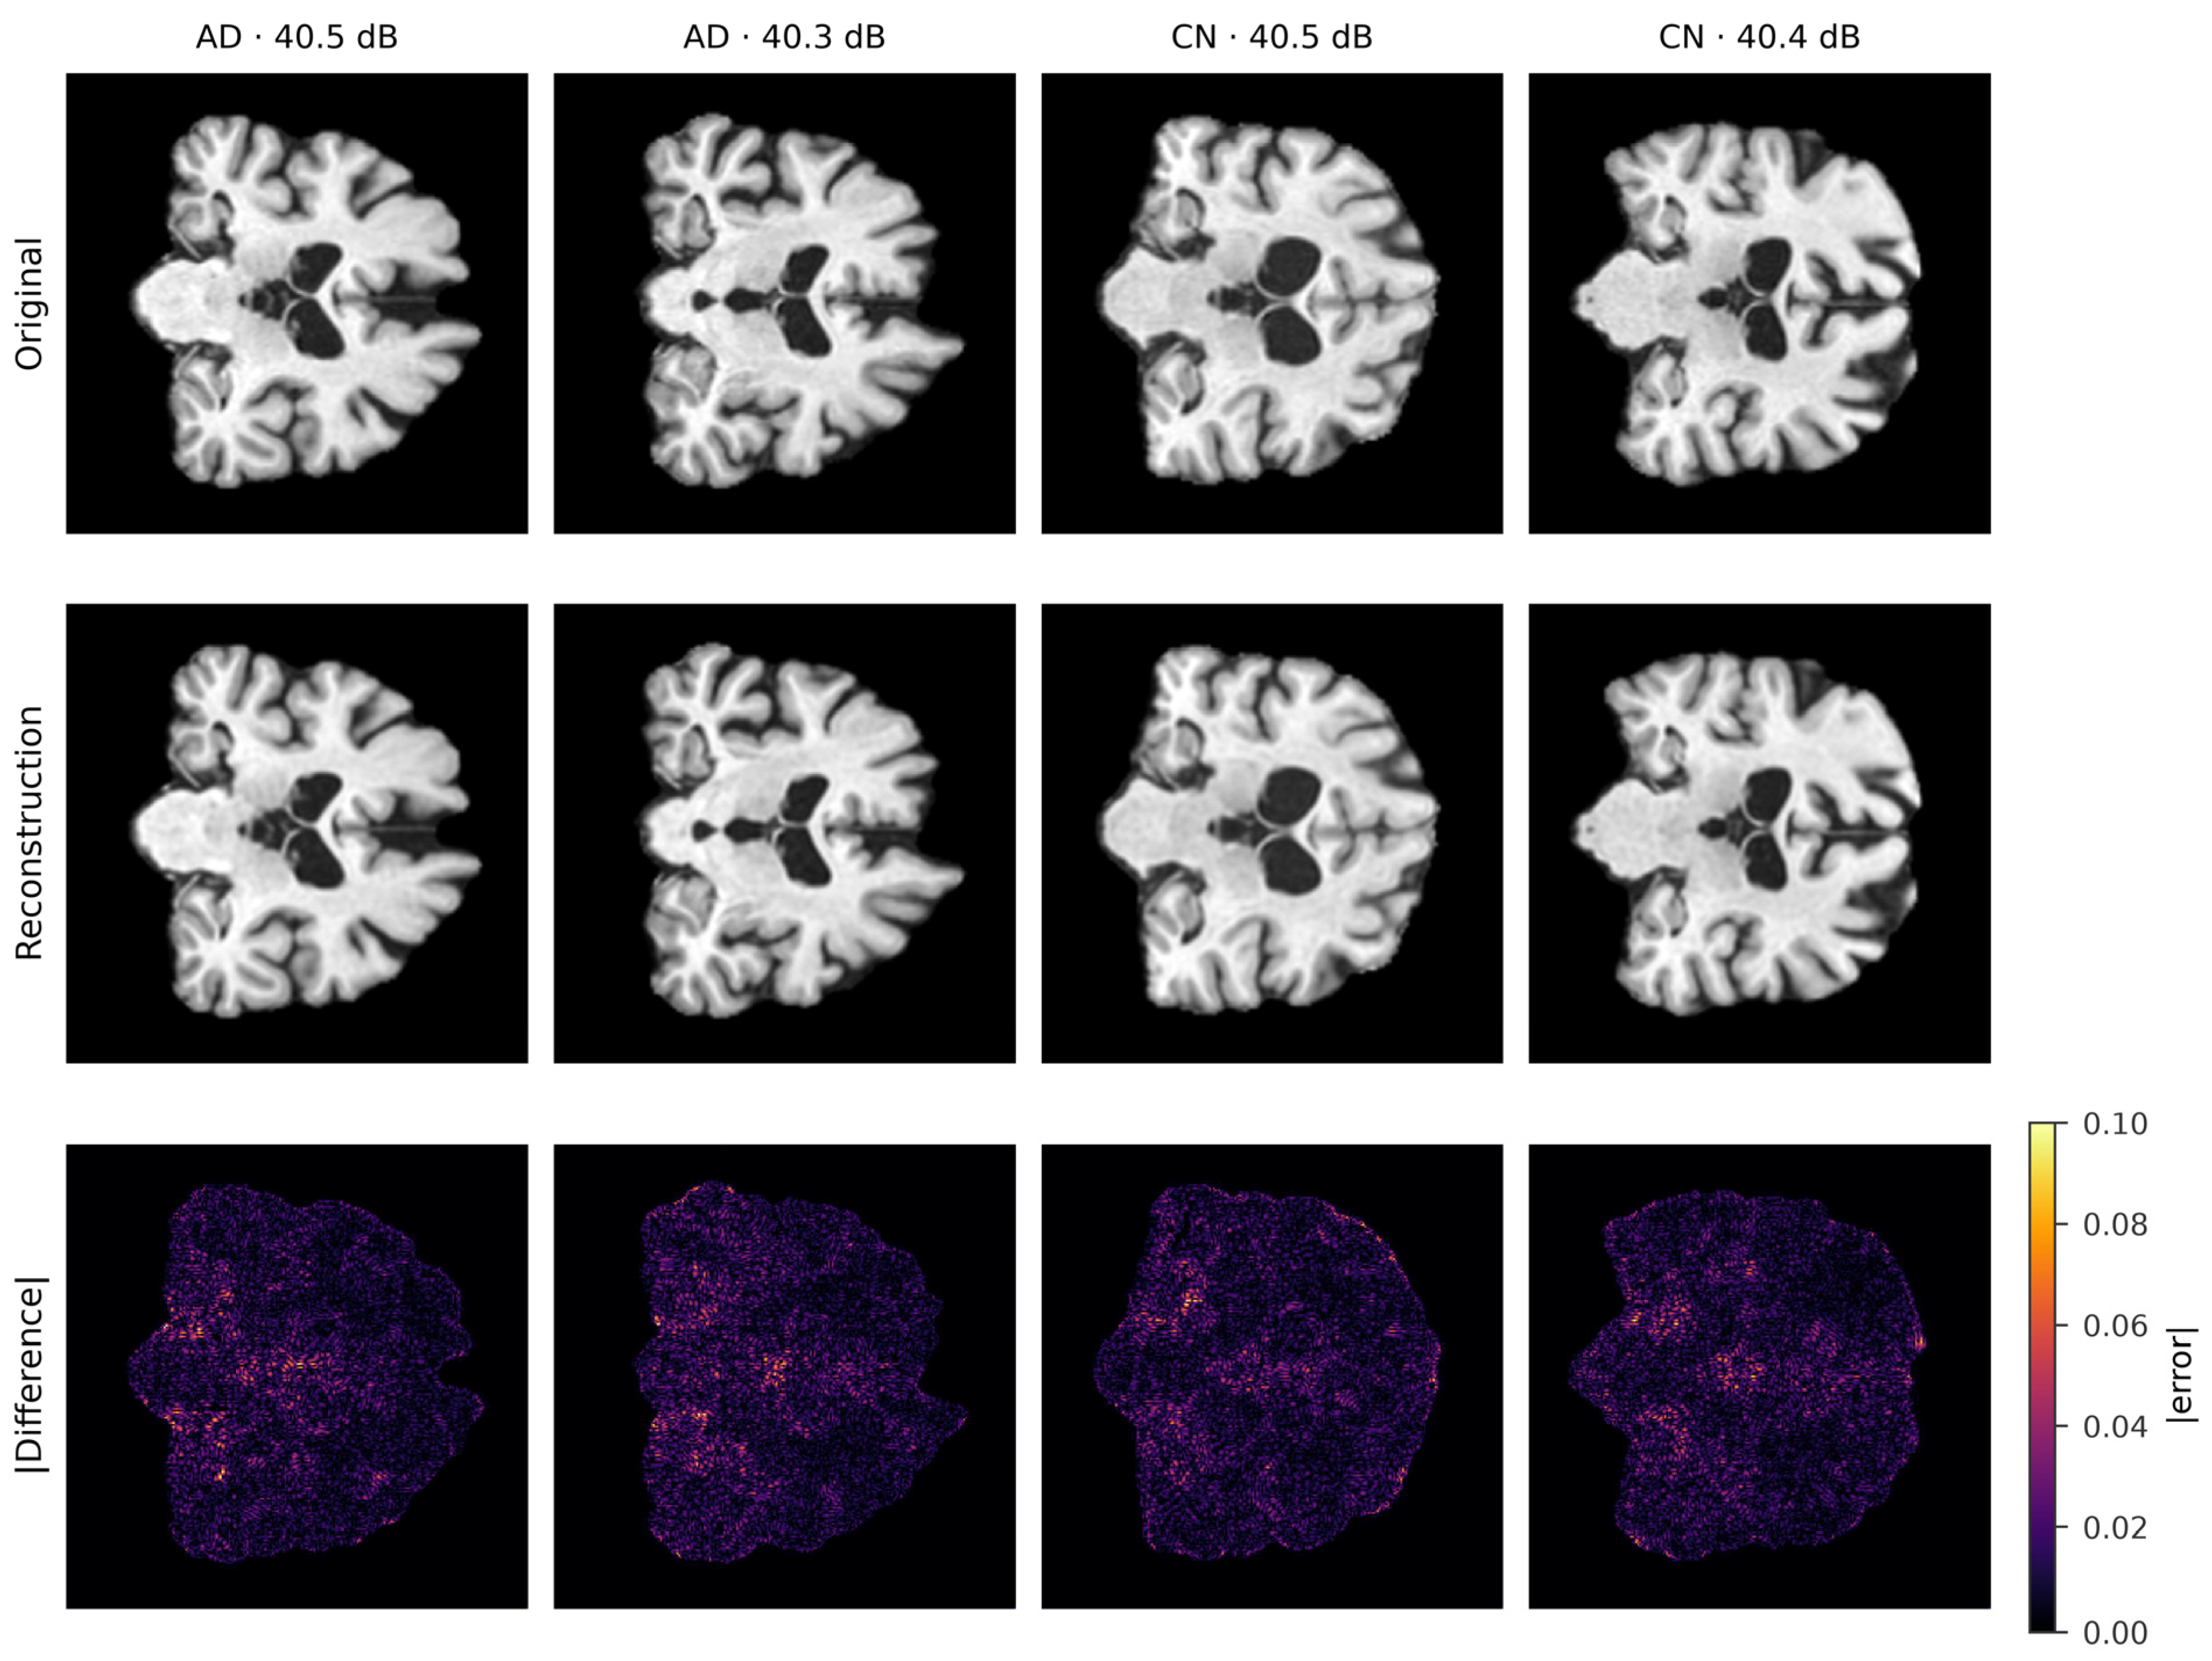
Autoencoder reconstruction quality on held-out test slices. Each column shows one example mid-brain slice at the hippocampal level, giving two Alzheimer’s disease (AD) cases and two cognitively normal (CN) cases. Rows show the original (top), reconstruction (middle), and absolute per-pixel difference (bottom), with difference maps windowed to [0, 0.10] in normalised-intensity units. Each column header reports the peak signal-to-noise ratio (PSNR) of that slice. Over the full test set (n = 880 slices), the autoencoder reached a mean PSNR of 38.66 dB and a mean structural similarity (SSIM) of 0.989, and reconstruction error stayed low for both classes with no visible class-dependent bias.
Artigo original
Fallah S, Herzog NJ., J Imaging, 2026-09-09
Imagens reproduzidas do artigo original sob a licença informada pelo periódico: Licensee MDPI, Basel, Switzerland. This article is an open access article distributed under the terms and conditions of the Creative Commons Attribution (CC BY) license.