- Published on
IA para bvFTD: o que a ressonância acrescentou
- Authors
- Name
- Michel Fernandes
- @michelpf
Pergunta do estudo
O estudo perguntou se uma inteligência artificial baseada em ressonância magnética estrutural T1 conseguiria melhorar a classificação entre três grupos: variante comportamental da demência frontotemporal (bvFTD), doença de Alzheimer (AD) e controles saudáveis (HC). O problema clínico é relevante porque a bvFTD pode ser confundida com outras demências e é muito menos frequente nas bases de dados. Em aprendizado de máquina, isso cria desbalanceamento: o modelo tende a aprender melhor as classes numerosas e a errar mais a classe rara.
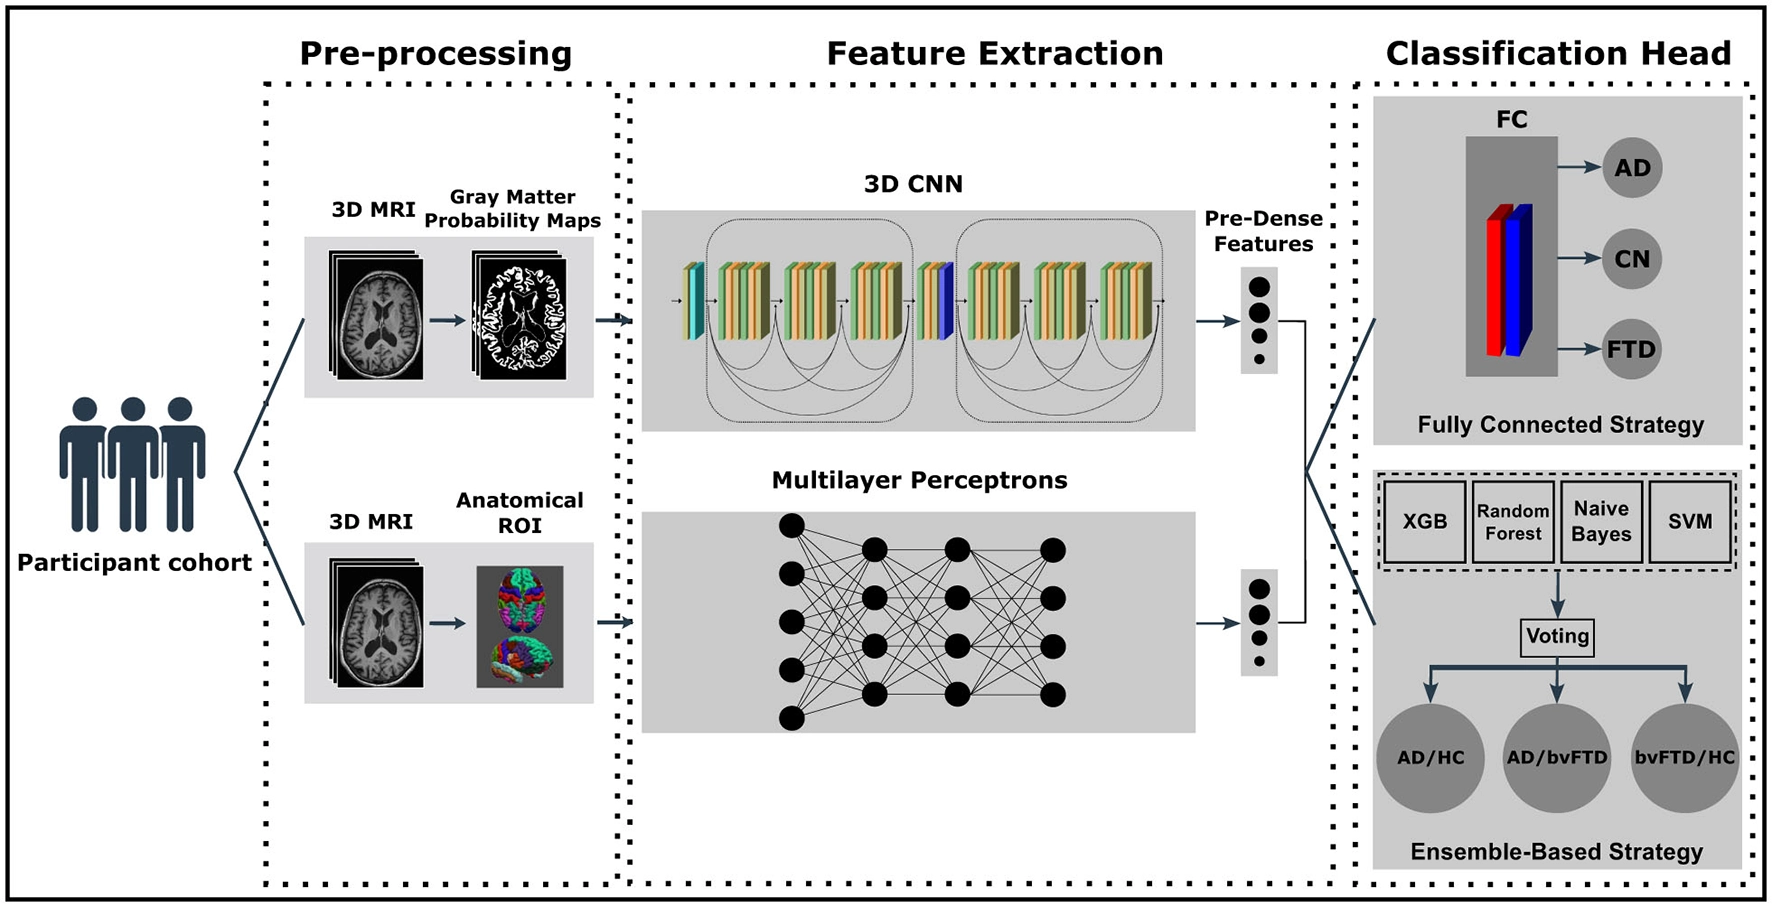
A proposta dos autores foi combinar dois tipos de informação extraídos da mesma MRI T1. A primeira era uma representação espacial, aprendida automaticamente por uma rede convolucional 3D a partir de mapas de substância cinzenta. A segunda era uma representação tabular, composta por volumes regionais anatômicos, processada por uma rede MLP. Portanto, “multimodal” aqui não significa juntar MRI, PET, líquor, genética e testes cognitivos. Significa fundir duas representações diferentes da mesma modalidade de imagem estrutural.
Coorte ADNI e demais bases usadas
A ADNI, Alzheimer’s Disease Neuroimaging Initiative, foi uma das coortes incluídas, mas o estudo não foi exclusivamente ADNI. Os autores reuniram exames de 5.928 participantes de várias fontes: ADNI, AIBL, ARWiBo, BrainLat, DESCRIBE, EDSD, MIRIAD, NACC, NIFD e OASIS. O texto fornecido não informa resultados separados por coorte nem quantos participantes vieram especificamente da ADNI.
A amostra total tinha 3.415 controles saudáveis, 2.276 pessoas com Alzheimer e 237 com bvFTD. Assim, antes do aumento artificial de dados, a bvFTD representava cerca de 4% do conjunto. Esse é um ponto central: a dificuldade do estudo não era apenas classificar três diagnósticos, mas fazer isso quando a classe de maior interesse clínico era muito pequena.
Os exames passaram por controle de qualidade, com exclusão de imagens de baixa qualidade, baixo sinal-ruído ou artefatos. A divisão foi feita em 70% treino, 15% validação e 15% teste, de forma estratificada. O artigo relata que as mesmas partições foram usadas nos experimentos, e que as métricas foram calculadas apenas no teste.
Para reduzir o desbalanceamento, os autores aplicaram data augmentation apenas nos casos de bvFTD. Foram escolhidos 140 exames de bvFTD, cerca de 60% desse grupo, e gerada uma versão artificial para cada um. As transformações foram: deformação elástica aleatória, alteração aleatória de intensidade gamma e distorção aleatória de campo de bias. Com isso, a bvFTD passou de 237 para 377 amostras, ou 6,2% do total. Como a ampliação ocorreu antes da divisão dos dados, havia risco de vazamento; os autores afirmam ter usado divisão por grupos, mantendo cada imagem original e suas versões aumentadas sempre na mesma partição.
Features e variáveis de entrada: o centro do modelo
As features principais vieram de duas trilhas. A primeira trilha usou mapas probabilísticos de substância cinzenta. Esses mapas foram derivados das imagens T1 depois de várias etapas: correção de bias N4, registro ao espaço MNI com template ICBM152, normalização de intensidade com truncamento de outliers e escalonamento global, extração do cérebro com HD-BET e segmentação tecidual com Atropos. A segmentação classificou voxels em substância cinzenta, substância branca e líquor, mas o estudo destaca os mapas de substância cinzenta como entrada para as análises posteriores. O tamanho final do mapa probabilístico foi 193 × 229 × 193. Em termos práticos, cada participante era representado por um volume 3D de um canal, no qual cada voxel continha uma probabilidade de pertencer à substância cinzenta.
Essa representação voxel-wise é rica, mas pouco interpretável diretamente. Ela preserva a geometria tridimensional do cérebro e permite que a CNN aprenda padrões distribuídos, por exemplo combinações de regiões com maior ou menor probabilidade de substância cinzenta. O artigo não lista manualmente esses voxels como variáveis individuais, nem aplica um ranking prévio. A seleção e compressão ocorrem dentro da própria rede.
A segunda trilha usou features anatômicas regionais. Os autores processaram as MRI com FastSurfer para segmentação cortical e subcortical, usando o atlas DKT. Para cada participante, foram extraídos volumes regionais. Esses volumes foram normalizados pelo volume intracraniano total estimado, e organizados em uma matriz tabular junto com idade normalizada e sexo. O texto afirma que a entrada do MLP era um vetor unidimensional por sujeito contendo volumes corticais e subcorticais normalizados. Contudo, não informa o número exato de regiões, o número final de variáveis tabulares nem a codificação usada para sexo.
O estudo não relata uso de testes cognitivos, medidas funcionais, PET, genética, APOE, biomarcadores de líquor, biomarcadores sanguíneos, escolaridade ou escalas clínicas como entrada do modelo. Também não descreve tratamento específico para valores ausentes nessas variáveis. Para as imagens, houve exclusão por qualidade; para idade, sexo e volumes regionais, o texto fornecido não informa se houve faltantes ou imputação.
Não houve seleção clássica de features, como PCA, LASSO, filtro estatístico ou eliminação por importância. A redução de dimensionalidade foi aprendida. Na CNN, convoluções, blocos DenseNet, camadas de transição e global max-pooling transformaram o volume 3D em um vetor fixo. No MLP, o vetor regional passou por camadas de 256, 128, 64 e 32 neurônios. Features da penúltima camada foram extraídas para a fusão. Antes de combinar os ramos, os vetores derivados da CNN e do MLP foram normalizados separadamente e projetados por camadas treináveis de 128 neurônios cada. Depois foram concatenados, formando uma representação fusionada de 256 dimensões. O tamanho do vetor CNN antes dessa projeção não foi informado.
A motivação para fundir esses grupos de features é plausível: os mapas de substância cinzenta capturam padrões espaciais finos, enquanto os volumes regionais oferecem medidas anatômicas mais explícitas. Mas as duas fontes não são independentes. Ambas derivam da mesma MRI T1 e podem carregar informações parcialmente redundantes sobre atrofia.
Método de IA e estratégias de fusão
A ramificação de imagem usou uma 3D-DenseNet. Diferente de redes 2D, que analisam fatias, uma CNN 3D processa o volume cerebral e pode aprender relações espaciais entre regiões. A arquitetura começou com uma convolução 3D de 10 filtros 7 × 7 × 7, stride 2, seguida por max-pooling 3D. Depois vieram blocos densos, nos quais cada camada recebe mapas das camadas anteriores. As operações incluíram batch normalization, ReLU e dropout. Camadas de transição reduziram canais e dimensões espaciais. Ao final, global max-pooling agregou a informação em um vetor.
A ramificação tabular usou um MLP para os volumes regionais, idade e sexo. A arquitetura tinha quatro camadas densas decrescentes, com 256, 128, 64 e 32 neurônios, ReLU e dropout de 0,3 após a quarta camada. A saída tinha três neurônios softmax para bvFTD, AD e HC. O treino usou Adam, taxa de aprendizado de 10⁻³, batch de 32, até 100 épocas, early stopping e focal loss, uma função útil em cenários de desbalanceamento.
Na fusão totalmente conectada, os embeddings de 128 dimensões de cada ramo foram concatenados. A representação combinada passou por camada densa de 128 neurônios, dropout de 0,5 e softmax de três classes. O treino usou Adam, taxa de 10⁻⁴, entropia cruzada categórica, early stopping e pesos de classe.
Na fusão por ensemble, a representação fusionada alimentou quatro classificadores: SVM com kernel RBF, Random Forest, Naive Bayes gaussiano e XGBoost. As probabilidades foram combinadas por votação suave ponderada. Os pesos foram 0,3 para SVM, 0,2 para Naive Bayes, 0,2 para Random Forest e 0,3 para XGBoost. O artigo afirma que esses pesos foram definidos em experimentos-piloto e não otimizados no teste.
Foram avaliadas 12 configurações de CNN, variando filtros, número de blocos DenseNet e taxa de aprendizado. Os resultados foram relatados como média e desvio-padrão entre essas configurações, o que mostra variabilidade entre escolhas de hiperparâmetros em vez de apenas o melhor caso.
Resultados quantitativos
Na classificação multiclasse, o augmentation sozinho quase não alterou a acurácia global: 0,713 ± 0,034 no baseline contra 0,716 ± 0,030 com augmentation, p = 0,79. Mas o efeito por classe foi diferente. O F1 de Alzheimer mudou de 0,64 ± 0,031 para 0,62 ± 0,04, sem significância. Em controles, foi de 0,781 ± 0,032 para 0,784 ± 0,038, também sem diferença. Em bvFTD, porém, o F1 subiu de 0,39 ± 0,10 para 0,54 ± 0,07, p = 0,001. Isso sugere que o aumento artificial ajudou principalmente a classe minoritária.
A fusão de features trouxe ganho mais amplo. A acurácia da configuração fusionada chegou a 0,75 ± 0,017, com p = 0,006. O F1 foi 0,67 ± 0,02 para Alzheimer, p = 0,02; 0,66 ± 0,04 para bvFTD, p = 0,002; e 0,80 ± 0,02 para controles, sem significância estatística reportada como relevante, p = 0,10.
As AUCs também melhoraram com a fusão: 0,82 ± 0,01 para Alzheimer, p = 0,002; 0,89 ± 0,01 para bvFTD, p = 0,01; e 0,84 ± 0,008 para controles, p = 0,002. Na estratégia de ensemble, o texto descreve melhora em várias tarefas binárias, especialmente AD versus HC e bvFTD versus HC. A separação AD versus bvFTD continuou difícil, com pequenas quedas em acurácia e F1 em alguns cenários. Os valores exatos das tabelas binárias não aparecem no trecho fornecido, então não devem ser inferidos.
Para interpretar a CNN, os autores usaram Layer-wise Relevance Propagation. Em AD, apareceram regiões distribuídas, incluindo áreas frontais, parietotemporais e hipocampo direito. Em bvFTD, a relevância concentrou-se em estruturas frontais e no prosencéfalo basal colinérgico. Em controles, hipocampo, ínsula e tálamo tiveram alta relevância. Esses mapas indicam contribuição para a decisão do modelo; não provam causalidade nem substituem biomarcadores patológicos.
Utilidade clínica, limitações e o que não se pode concluir
A possível utilidade clínica está em apoiar a diferenciação entre bvFTD, Alzheimer e controles a partir de MRI estrutural, exame comum na investigação de demência. O estudo sugere que combinar features espaciais aprendidas com volumes regionais anatômicos pode ser melhor do que usar apenas uma CNN, especialmente quando a classe bvFTD é rara.
Ainda assim, há limitações claras. A bvFTD continuou pouco representada mesmo após augmentation. A proporção de aumento foi escolhida empiricamente, não por busca exaustiva. O texto não descreve validação prospectiva, nem validação externa deixando uma coorte inteira fora do treino. Também não permite descartar efeitos de scanner, centro ou coorte correlacionados com diagnóstico. Como idade e sexo entram no modelo, eles podem ajudar a classificação, mas também refletir diferenças demográficas entre grupos.
Também não se pode concluir que a ferramenta diagnostique bvFTD sozinha, que seja superior a especialistas, que funcione em pacientes com quadros incertos ou estágios iniciais, ou que PET, genética e biomarcadores sejam dispensáveis. A conclusão prudente é mais restrita: neste conjunto multicohorte desbalanceado, a fusão tardia de duas representações de MRI T1 melhorou métricas de classificação, com benefício importante para bvFTD, mas ainda exige validação clínica mais rigorosa.
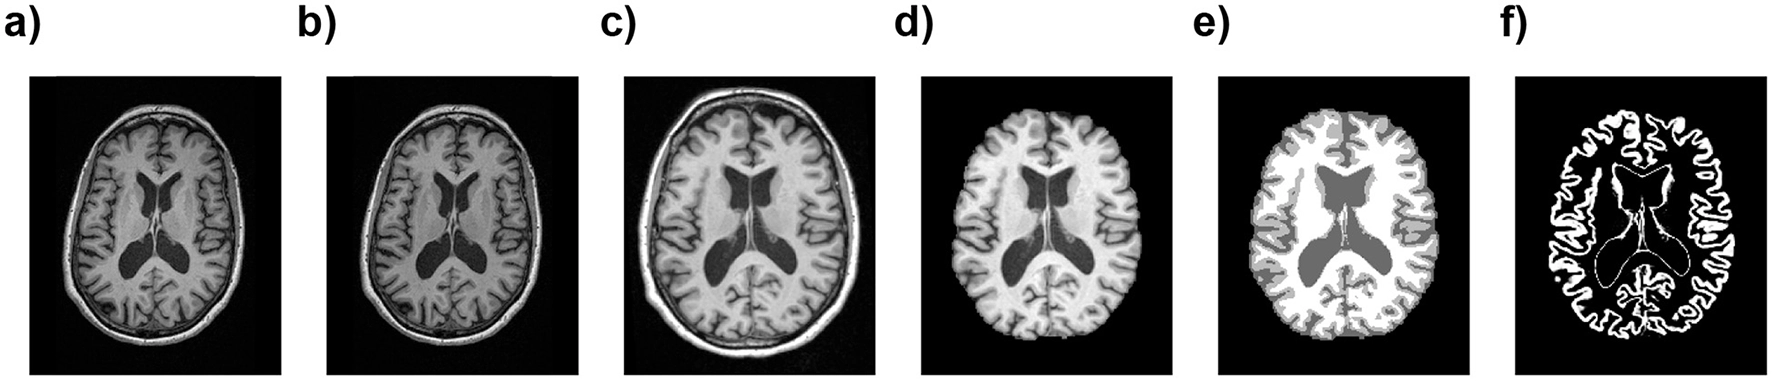
Overview of the preprocessing steps. The figure shows (a) the raw data, and the pipeline which includes (b) bias field correction, (c) registration to the MNI standard space, (d) brain extraction, (e) tissue segmentation into major brain tissue classes, and (f) generation of probability maps for gray matter. For visualization purposes, only representative axial slices from a single subject are shown at each step.
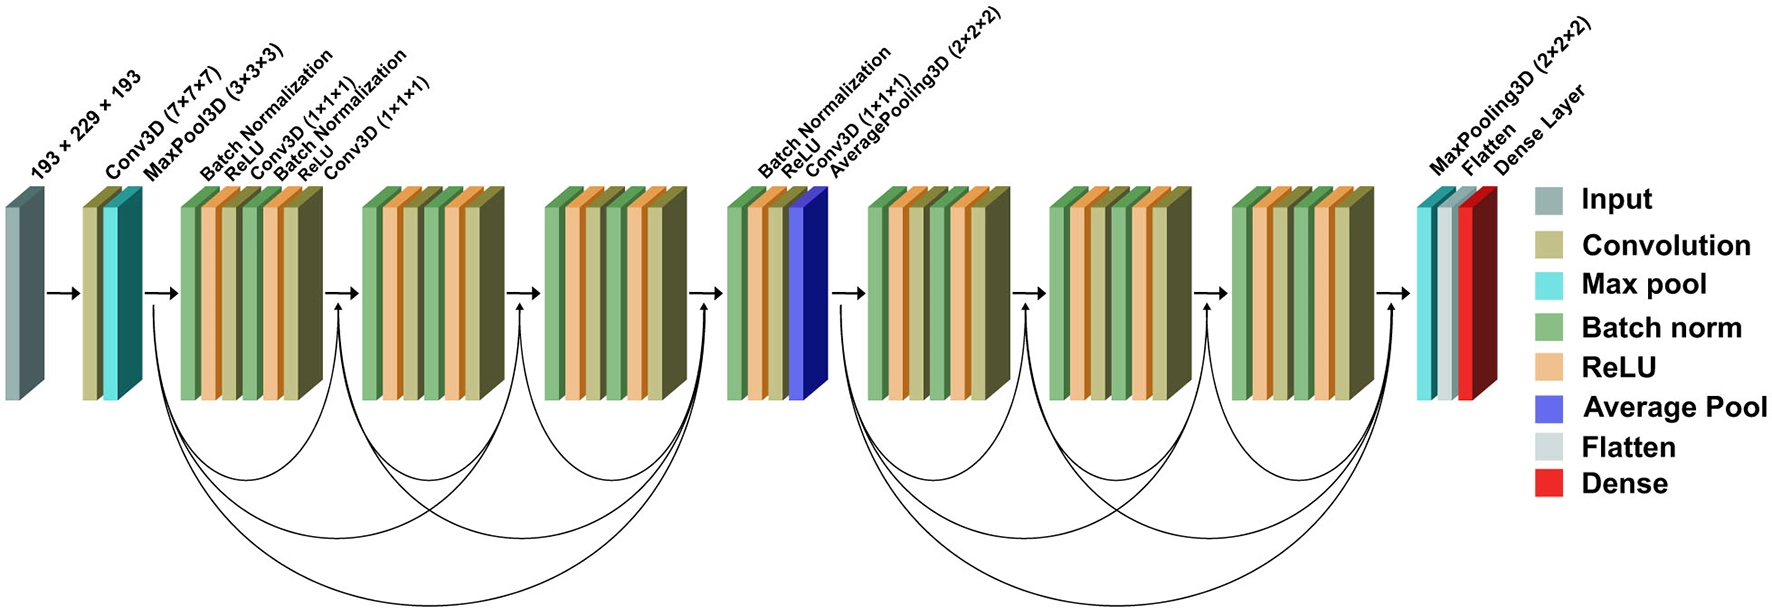
Architecture of the proposed 3D-DenseNet model for deep feature extraction. The network processes 3D MRI data as input and learns discriminative spatial representations through stacked 3D convolutional layers. For clarity, only selected block names and key parameters are displayed above some blocks.
Leia também: IA com ressonância magnética para detectar Alzheimer, IA generativa e ressonâncias sintéticas no Alzheimer, Alzheimer precoce e tardio: o que a imagem cerebral revela.
Artigo original
Hybrid multimodal late fusion frameworks for bvFTD classification in imbalanced dementia datasets.
Ramedani M, Terli JC, Singh D, Peters O, Hellmann-Regen J, Priller J, Spruth EJ, Spottke A, Boehlen A, Weydt P, Wüllner U, Dinter E, Günther R, Wiltfang J, Schott BH, Düzel E, Glanz W, Buerger K, Janowitz D, Levin J, Stockbauer A, Mladinov M, Prudlo J, Hermann A, Synofzik M, Mengel D, Petzold GC, Schneider A, Lüsebrink F, Hetzer S, Dechent P, Ewers M, Scheffler K, Stöcklein S, Teipel S, Dyrba M., Front Aging Neurosci, 2026-09-16
Imagens reproduzidas do artigo original sob a licença informada pelo periódico: https://creativecommons.org/licenses/by/4.0/This is an open-access article distributed under the terms of the Creative Commons Attribution License (CC BY). The use, distribution or reproduction in other forums is permitted, provided the original author(s) and the copyright owner(s) are credited and