- Published on
IA no Alzheimer: o que os modelos usam para aprender
- Authors
- Name
- Michel Fernandes
- @michelpf
Pergunta do estudo: IA para diagnosticar ou só para acertar benchmarks?
O artigo de Menezes, Barbosa e Rodrigues é uma revisão sistemática, não um estudo que treina um novo modelo único. A pergunta principal foi como a inteligência artificial vem sendo usada para diagnóstico e prognóstico da doença de Alzheimer: quais bases de dados são mais usadas, quais modalidades entram nos modelos, que algoritmos predominam, que desempenho é relatado e que barreiras ainda impedem a tradução clínica.
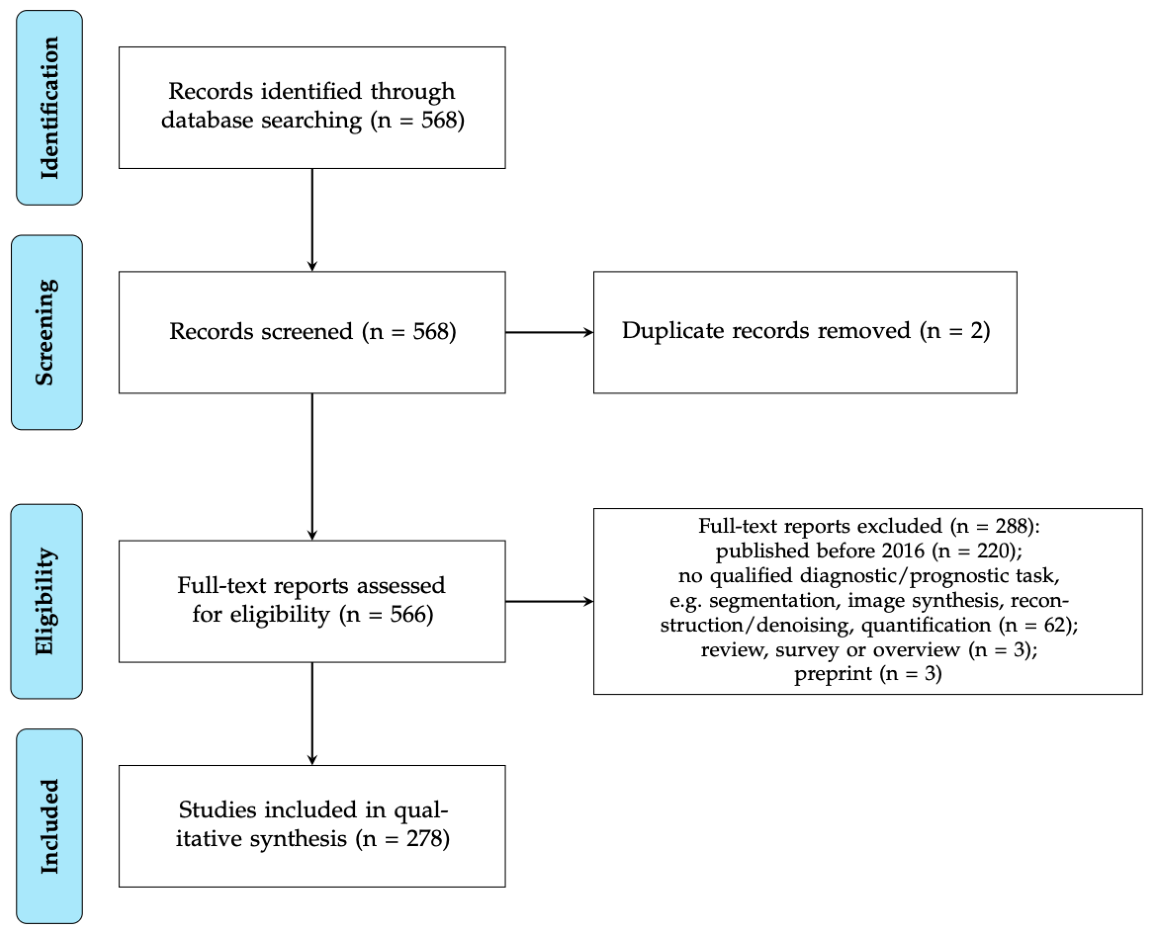
Foram incluídos estudos publicados entre 2016 e 2026 com modelos de machine learning ou deep learning para tarefas como distinguir Alzheimer de controles cognitivamente normais ou prever conversão de comprometimento cognitivo leve, MCI, para demência por Alzheimer. A busca encontrou 568 registros; após remoção de duplicatas e exclusões, 278 estudos entraram na síntese qualitativa.
A revisão parte de uma tensão importante. Na prática, o diagnóstico clínico combina história, evolução, cognição, funcionalidade, imagem e biomarcadores. Muitos modelos de IA, porém, aprendem a separar classes definidas em coortes de pesquisa. O estudo pergunta se a literatura está produzindo sistemas realmente generalizáveis ou apenas bons resultados em condições controladas.
A coorte ADNI e a dependência de poucas bases
A Alzheimer’s Disease Neuroimaging Institute, ADNI, domina a área. Ela apareceu em 160 dos 278 estudos, cerca de 58%. Entre os 105 estudos multimodais, aproximadamente 69% usaram ADNI. Isso ocorre porque a coorte reúne, para muitos participantes, informações longitudinais e alinhadas de imagem, biomarcadores, cognição, genética e diagnóstico.
Essa riqueza torna a ADNI atraente para IA: o mesmo indivíduo pode ter ressonância magnética, PET, testes cognitivos, líquido cefalorraquidiano e dados genéticos. Ao mesmo tempo, a ADNI é uma coorte de pesquisa, com protocolos padronizados e participantes selecionados. Ela não representa automaticamente a diversidade de uma clínica de memória comum, onde há comorbidades, escolaridade variável, scanners diferentes e trajetórias clínicas menos “limpas”.
Outras bases foram menos frequentes: coortes clínicas institucionais, sobretudo em EEG e MEG; OASIS, em 20 estudos; conjuntos do Kaggle, em 13; OpenNeuro, em 8; e bases como NACC, AIBL, MIRIAD, BioFIND, BioFINDER, CADDementia e DementiaBank apareceram esporadicamente. Só cerca de 8% dos estudos usaram mais de uma base, e validação externa verdadeira foi rara, em torno de 4%.
Features e variáveis de entrada: o que o modelo realmente viu
O ponto central da revisão é que “IA para Alzheimer” significa muitas coisas diferentes, dependendo das variáveis de entrada. O artigo agrupa features por modalidade, mas não fornece uma lista completa nem a quantidade exata de variáveis usadas em cada um dos 278 estudos. Portanto, não é possível dizer, a partir do texto fornecido, quantos features cognitivos, genéticos ou de imagem entraram em cada modelo final.
Em demografia e clínica, a revisão reconhece o uso de informações clínicas e populacionais, mas não detalha uma lista padronizada. Idade, sexo ou escolaridade podem ser comuns na área, porém o artigo fornecido não permite afirmar quais delas foram usadas de forma consolidada nem como foram codificadas.
Nos testes cognitivos e funcionais, aparecem exemplos como MMSE, MoCA, CDR, RAVLT, FAQ e ECog. Esses instrumentos viram números: pontuações globais, domínios ou, em alguns estudos, possivelmente subescalas. O MMSE e o MoCA resumem cognição global; o CDR expressa gravidade clínica; o RAVLT mede aprendizagem e memória verbal; FAQ e ECog avaliam funcionamento cotidiano. A revisão não informa, para todos os estudos, se foram usados totais, itens individuais ou combinações.
Na ressonância magnética estrutural, os features representam anatomia e atrofia cerebral. A revisão cita estratégias baseadas em regiões de interesse, atlas como AAL, registro como HAMMER e texturas como GLCM. Em termos simples, imagens são convertidas em números: volumes regionais, padrões de intensidade, medidas de forma ou textura. Em deep learning, essa conversão pode ser automática: uma CNN recebe fatias 2D, volumes 3D ou projeções e aprende representações internas sem que cada região seja explicitamente escolhida pelo pesquisador.
Em fMRI de repouso, as entradas derivam do sinal BOLD. A revisão menciona ALFF, ReHo e conectividade funcional. ALFF resume amplitudes de flutuações lentas; ReHo descreve homogeneidade regional; conectividade funcional transforma relações entre regiões cerebrais em matrizes ou grafos. Em DTI ou DWI, os features vêm da microestrutura da substância branca e podem usar atlas como JHU, mas o trecho fornecido não detalha métricas específicas.
No PET, os features capturam metabolismo ou deposição molecular. FDG-PET mede metabolismo cerebral; PET amiloide, como AV-45, mede depósito de beta-amiloide. A revisão cita SUVR, razão padronizada de captação, que representa o sinal de uma região normalizado por uma referência. Essa é uma forma explícita de representação e normalização do PET.
Nos biomarcadores de líquor, exemplos incluem Aβ40, Aβ42, tau, p-tau, p-tau181 e p-tau217. São medidas laboratoriais relacionadas à patologia amiloide e tau. O texto não informa se os estudos usaram valores absolutos, razões entre marcadores ou transformações. Na genética, aparecem APOE e SNPs; a revisão não especifica número de variantes nem esquemas de codificação.
EEG e MEG entram como sinais eletrofisiológicos, especialmente em coortes clínicas. A revisão destaca o interesse por EEG por ser mais acessível, portátil e não invasivo, mas o trecho fornecido não detalha bandas, janelas, conectividade ou outros descritores. Por isso, qualquer lista minuciosa desses features seria extrapolação.
O pré-processamento também variou muito. O artigo afirma que diferenças em pipelines, representações e validação impediram uma meta-análise. Além do SUVR em PET, não há resumo consolidado de normalização, codificação, imputação ou harmonização. Quando informações estavam ausentes nos artigos originais, os revisores registraram como “not specified”.
Métodos de IA e validação
Os métodos se dividiram quase igualmente. Dos 278 estudos, 139 usaram machine learning clássico e 134 usaram deep learning; poucos foram híbridos. Entre modelos clássicos, SVM foi o mais comum, presente em 21,9% dos estudos e em cerca de 44% dos modelos apenas de ML. Em estudos multimodais, SVMs apareceram com estratégias de múltiplos kernels para combinar dados heterogêneos.
Entre redes neurais, CNNs foram as mais frequentes: 18,0% dos estudos, cerca de um terço do subconjunto de deep learning. Muitos estudos de imagem usaram CNNs 2D com transferência de aprendizado, como VGG, ResNet ou DenseNet; outros usaram CNNs 3D ou redes com múltiplos ramos. Autoencoders, redes totalmente conectadas, LSTM, GRU, GNNs, transformers e GANs apareceram menos.
A validação foi um ponto frágil. K-fold cross-validation apareceu em pouco mais de 50% dos estudos; hold-out simples em cerca de 28,8%; LOOCV em 37 estudos. Métodos mais rigorosos foram raros: validação cruzada aninhada em 11 estudos e validação externa em cerca de 4%.
Resultados quantitativos: desempenho promissor, comparação difícil
Para prever conversão de MCI para Alzheimer, a acurácia mediana foi 86,0% em estudos multimodais e 80,9% em unimodais. Na comparação global, a diferença entre single-modal e multi-modal foi estatisticamente significativa para acurácia, p=0,015, mas não para AUC, p=0,090. Isso sugere vantagem possível da integração de modalidades, mas não prova superioridade universal.
Comparando ML e DL, os autores não encontraram diferenças estatisticamente significativas dentro dos grupos single-modal ou multi-modal na maioria das análises. Em MRI, a acurácia mediana foi 88,2% com ML e 90,6% com DL; a AUC mediana foi 0,90 e 0,92. Em PET, a acurácia mediana foi 87,2% com ML e 89,1% com DL; a AUC foi 0,86 e 0,92. Em EEG, as acurácias foram parecidas, 91,6% e 92,6%, mas a AUC mediana foi maior em DL, 0,98 contra 0,85.
As tarefas mais fáceis, como Alzheimer versus controles cognitivamente normais, chegaram em alguns estudos a cerca de 99% de acurácia. Já tarefas clinicamente mais difíceis, como distinguir estágios próximos ou prever progressão de MCI, ficaram com frequência entre 70% e 85%. Isso é esperado: separar extremos é mais simples do que prever transições em um continuum biológico.
Utilidade clínica, limitações e o que ainda não se pode concluir
A utilidade clínica potencial é grande. Um sistema confiável poderia apoiar triagem, priorizar exames caros, estimar risco de progressão e orientar planejamento de cuidado. Isso é relevante porque intervenções modificadoras de doença tendem a ser mais úteis em fases iniciais.
Mas a revisão mostra que a área ainda não está pronta para substituir julgamento clínico. A dependência da ADNI limita generalização; poucos estudos testam modelos em coortes independentes; e muitos resultados vêm de validação interna. Também há risco de redundância e vazamento conceitual: testes cognitivos, funcionalidade e diagnóstico clínico podem estar muito próximos das regras usadas para definir os próprios rótulos. A revisão não quantifica esse problema por estudo, mas identifica data leakage e transparência como preocupações.
Também não se pode concluir que uma feature cause Alzheimer porque melhora a classificação. Acurácia mede associação preditiva, não causalidade. Tampouco se pode afirmar que multimodalidade é sempre melhor: os resultados vêm de estudos heterogêneos, não de comparações pareadas sob o mesmo desenho. A mensagem final é que a IA já encontra padrões úteis em imagem, cognição, biomarcadores, genética e sinais neurais, mas precisa de features mais bem descritos, validação externa e populações mais diversas antes de virar ferramenta clínica robusta.
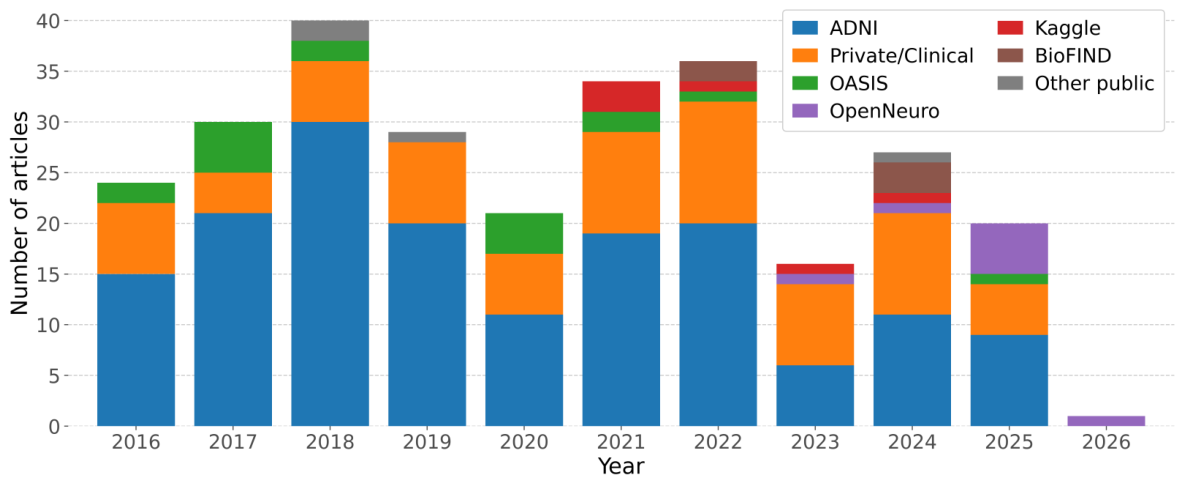
Distribution of dataset type usage among the included studies.
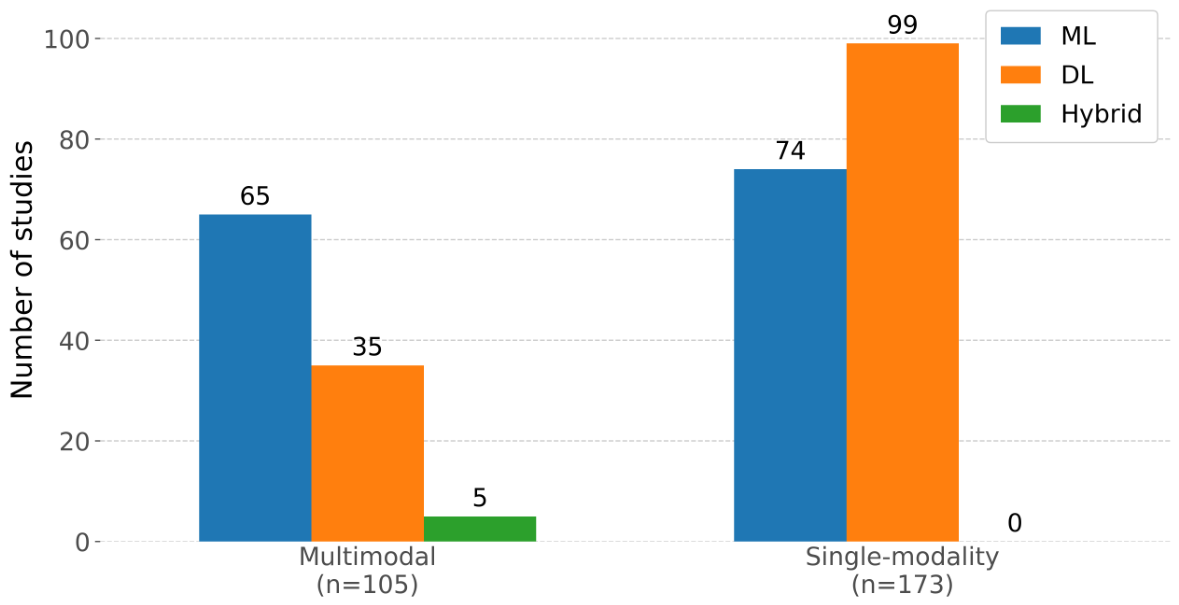
Distribution of classification approaches across the reviewed studies.
Artigo original
Menezes J, Barbosa MI, Rodrigues PM., Sensors (Basel), 2026-08-29
Imagens reproduzidas do artigo original sob a licença informada pelo periódico: Licensee MDPI, Basel, Switzerland. This article is an open access article distributed under the terms and conditions of the Creative Commons Attribution (CC BY) license.