- Published on
IA em neuroimagem neurológica: o que a revisão mostra sobre dados, features e limites clínicos
- Authors
- Name
- Michel Fernandes
- @michelpf
Pergunta do estudo e escopo real
O artigo revisado é uma revisão sistemática sobre inteligência artificial aplicada à imagem cerebral e ao diagnóstico assistido por computador de doenças neurológicas. A pergunta não foi “um novo modelo consegue diagnosticar melhor Alzheimer, AVC ou tumor?”, mas sim: que métodos de IA foram usados entre 2020 e junho de 2026, com quais modalidades de imagem, para quais doenças, usando quais bases, validações e métricas, e quais problemas ainda impedem tradução clínica confiável.
Isso muda a leitura dos achados. O trabalho não treinou um modelo único, não avaliou pacientes novos em tempo real e não fez meta-análise. Os estudos incluídos eram heterogêneos demais em doenças, protocolos, rótulos, métricas e desenhos de validação para calcular uma acurácia média defensável. Portanto, a revisão descreve tendências e fragilidades do campo; ela não prova que uma arquitetura, uma modalidade ou uma combinação de variáveis seja superior em todas as situações.
O texto também menciona a ADNI, frequentemente usada em demência, mas a revisão não é um estudo da coorte ADNI. A ADNI aparece como exemplo de recurso público maduro que favoreceu pesquisas em Alzheimer e demências. O artigo fornecido não informa, para a ADNI, número de participantes, visitas, subgrupos diagnósticos, lista de variáveis ou desempenho separado. Assim, qualquer detalhe específico sobre features da ADNI além dessa menção seria extrapolação.
Como a revisão foi conduzida
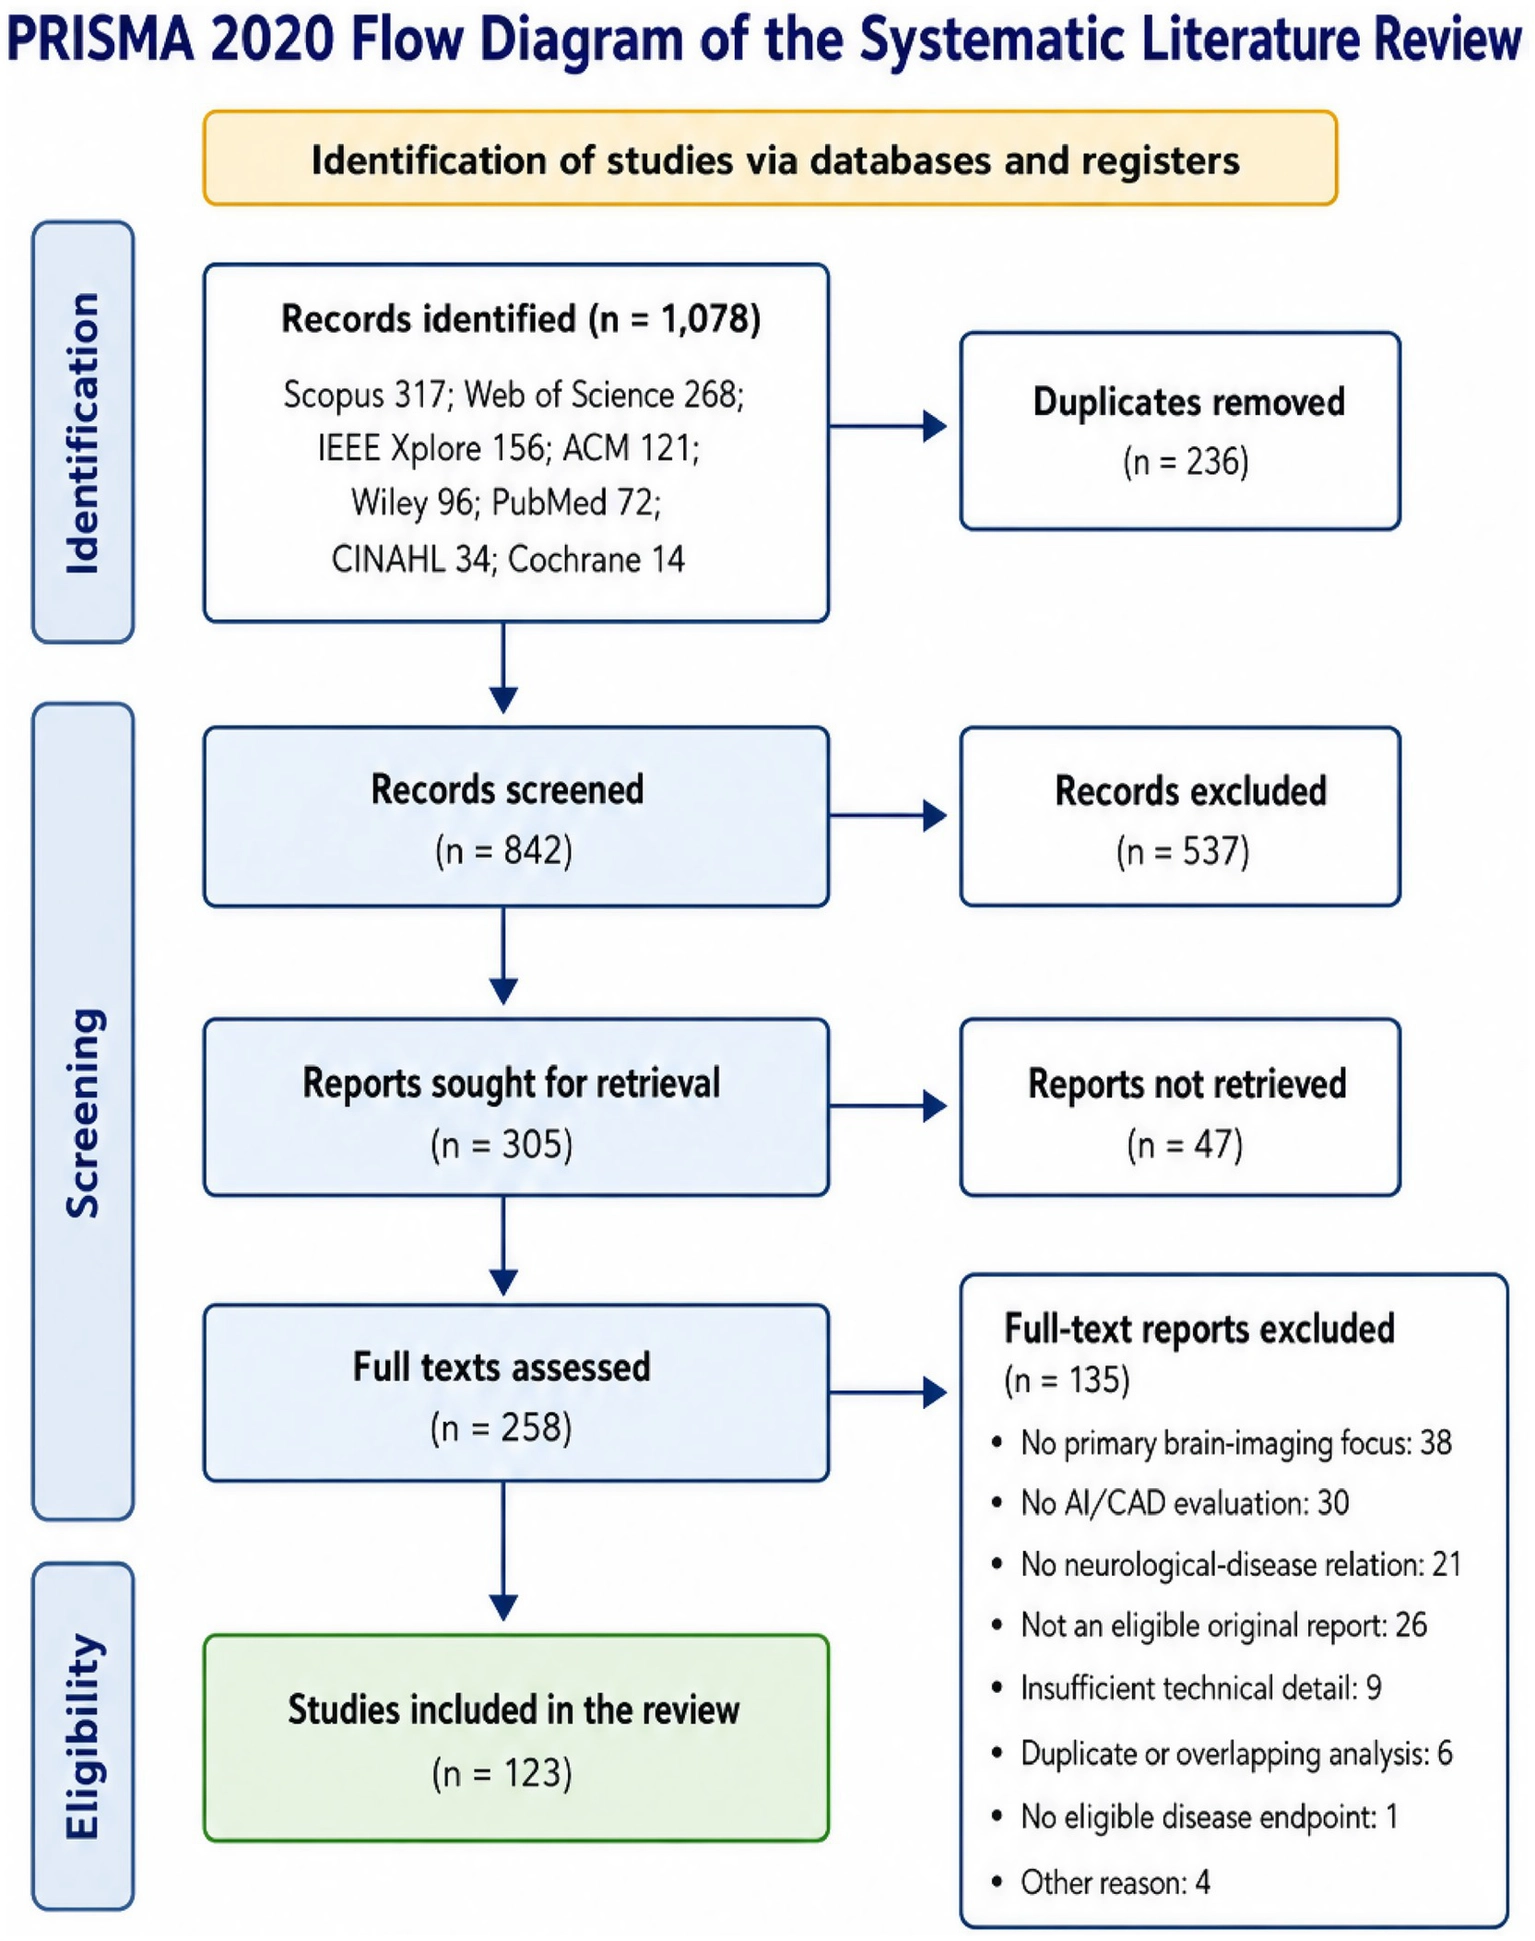
A revisão seguiu PRISMA 2020 e pesquisou oito fontes: Scopus, Web of Science, IEEE Xplore, ACM Digital Library, Wiley Online Library, PubMed/MEDLINE, CINAHL Complete e Cochrane Library. A janela foi de 1º de janeiro de 2020 a 30 de junho de 2026, com checagem posterior de referências e citações.
Foram identificados 1.078 registros. Após remover 236 duplicatas, restaram 842 registros únicos para triagem. Desses, 305 textos completos foram procurados; 47 não foram recuperados; 258 foram avaliados integralmente; e 123 estudos entraram na síntese final. Os 123 estudos corresponderam a 14,6% dos registros triados e 47,7% dos textos completos recuperados. Uma auditoria posterior reclassificou 14 registros de uma matriz anterior de 137 como contextuais ou inelegíveis.
Apenas estudos originais, revisados por pares, em inglês, com imagem cerebral humana ou informação EEG/MEG clinicamente relevante, IA ou aprendizado de máquina e ligação com doença neurológica foram elegíveis. Revisões, protocolos, editoriais, preprints não revisados e estudos sem foco primário em neuroimagem ficaram fora da base principal, embora alguns tenham sido citados como contexto.
Features e variáveis de entrada usadas pelos modelos
O aspecto mais importante da revisão é a variedade de features. Em alguns estudos, a entrada era a própria imagem; em outros, eram medidas derivadas, conectomas, descritores radiômicos, sinais neurofisiológicos ou dados clínicos combinados. O artigo, porém, não fornece uma tabela consolidada com o número de features por estudo, nem quantos chegaram ao modelo final. Quando a informação não estava disponível na extração, foi marcada como não recuperável, e não inferida.
A MRI foi a modalidade mais representada na codificação descritiva. O texto cita T1, T2, FLAIR, sequências sensíveis à suscetibilidade e imagens com contraste. Essas entradas podiam ser usadas diretamente por CNNs 2D ou 3D, em fatias ou volumes, ou convertidas em variáveis derivadas. Exemplos de derivados incluem superfícies corticais, volumes regionais, estruturas subcorticais e medidas morfométricas. Em glioma, AVC, esclerose múltipla e trauma, o modelo também podia receber ou produzir máscaras de lesão, segmentações anatômicas e volumes de anormalidade.
A CT apareceu sobretudo em cenários de urgência, como AVC e lesão traumática. As entradas descritas incluem CT sem contraste, angiografia por CT, perfusão por CT e imagem vascular. Dependendo da tarefa, a feature podia ser a fatia, o volume, um mapa de perfusão ou uma região a segmentar. As saídas mencionadas incluem detecção de hemorragia, triagem de oclusão de grande vaso, segmentação de infarto e quantificação de volume de lesão.
A fMRI foi representada de forma menos “anatômica” e mais relacional. O sinal BOLD costuma ser convertido em séries temporais regionais ou matrizes de conectividade. Nesses casos, a feature não é apenas um voxel, mas uma relação entre regiões cerebrais. Isso foi discutido para demência, epilepsia, Parkinson, autismo e distúrbios da consciência. A revisão alerta que essas features dependem fortemente de pré-processamento, construção de rede, definição de nós e arestas e controle de artefatos.
A difusão, incluindo DTI e modelos relacionados, foi descrita como forma de capturar organização da substância branca e integridade de tratos. O artigo não lista métricas específicas por estudo no trecho fornecido, mas afirma que descritores de difusão e medidas de tratos alimentaram classificadores tradicionais e modelos de conectividade.
PET e SPECT foram tratados como modalidades moleculares ou funcionais. As features podem representar metabolismo, amiloide, tau, transportador de dopamina ou outros sinais dependentes do traçador. Em doenças neurodegenerativas, isso complementa a MRI porque registra processos que podem não aparecer como atrofia estrutural. A revisão não apresenta comparação quantitativa entre traçadores nem número de variáveis PET/SPECT.
EEG e MEG entram como informação neurofisiológica de alta resolução temporal. O texto menciona formas de onda, contexto temporal e representações tempo-frequência, especialmente em epilepsia e previsão de crises. Aqui, a feature pode ser um segmento temporal, um padrão espectral ou uma representação aprendida por redes recorrentes, Transformers ou modelos híbridos.
Além das imagens, alguns estudos combinaram demografia, escores cognitivos, exames laboratoriais, genética, prontuários eletrônicos e observações longitudinais. A revisão cita essa multimodalidade como promissora, sobretudo para demência, estadiamento e prognóstico. Mas não informa quais variáveis clínicas específicas foram usadas em cada estudo, como idade ou sexo foram codificados, quais testes cognitivos entraram, nem se variáveis genéticas como APOE apareceram em modelos específicos. Portanto, a contribuição de cada feature clínica não pode ser quantificada a partir desta revisão.
Pré-processamento, seleção de features e ausências
A revisão codificou várias etapas de preparação dos dados: registro, normalização espacial, remoção do crânio, correção de campo de viés, reamostragem, padronização de intensidade, correção de artefatos, harmonização, aumento de dados, escalonamento de features e construção de redes. Em imagens estruturais, essas etapas tentam tornar cérebros e scanners comparáveis. Em fMRI e grafos, elas definem parcialmente a própria feature, porque mudar o parcelamento, o limiar ou a regra de conectividade muda a entrada do modelo.
Em modelos tabulares e radiômicos, o escalonamento de variáveis é relevante, especialmente para métodos como SVM. Em redes profundas, a representação pode ser aprendida diretamente da imagem, mas isso não elimina pré-processamento: skull stripping, normalização, reamostragem e harmonização ainda podem determinar o que a rede enxerga.
Sobre seleção e redução de dimensionalidade, o artigo menciona seleção de features em pipelines clássicos, autoencoders para redução de dimensão, aprendizado de representações e redes profundas que extraem padrões hierárquicos. Também alerta para um erro comum: escolher features antes da validação cruzada ou ajustar repetidamente o teste. A prática mais segura é manter seleção de features, ajuste de hiperparâmetros, calibração e escolha de limiar dentro do treinamento ou de um laço interno, preservando o laço externo para estimar desempenho.
Valores ausentes são um problema central em multimodalidade. MRI, PET, CT, EEG, cognição e genética nem sempre existem para os mesmos pacientes, nem são obtidos no mesmo momento. A revisão afirma que mecanismos flexíveis para lidar com missingness foram incomuns. Análise por casos completos pode selecionar pacientes mais investigados e menos representativos. GANs e síntese de modalidades foram citados como alternativas, mas o artigo enfatiza que imagens geradas precisam ser avaliadas pelo impacto no diagnóstico, não apenas por aparência plausível.
Métodos de IA e resultados quantitativos
A revisão agrupou os métodos em 15 famílias principais, incluindo aprendizado de máquina tradicional, SVM, ensembles de árvores, classificadores probabilísticos ou de vizinhos, CNNs 2D e 3D, U-Net e redes densas de segmentação, autoencoders, GANs, redes recorrentes, atenção, Transformers, híbridos CNN-Transformer, GNNs, aprendizado auto-supervisionado ou por transferência, multimodalidade, aprendizado federado e modelos fundacionais.
Modelos tradicionais continuaram relevantes quando os dados eram tabulares, radiômicos, morfométricos ou de conectividade e as amostras eram menores. CNNs e U-Nets foram frequentes para classificação e segmentação de lesões visíveis. Transformers e atenção surgiram como tendência recente para relações globais e temporais, mas a revisão não demonstra vantagem universal. GNNs foram usados quando o cérebro foi representado como grafo, com regiões como nós e conexões como arestas.
Os resultados quantitativos mais firmes são os da própria revisão: 1.078 registros identificados, 842 triados, 258 textos completos avaliados e 123 estudos incluídos. Um conjunto bibliométrico auxiliar de 439 publicações, de 2014 a junho de 2026, mostrou crescimento da área, mas não integrou a evidência PRISMA principal. Em cobertura clínica, AVC, Alzheimer/demências e tumores cerebrais foram os temas mais densos; Parkinson, epilepsia e esclerose múltipla formaram grupos menores; trauma, autismo e distúrbios da consciência foram menos frequentes.
A revisão não calcula acurácia média, sensibilidade média ou AUC combinada. Essa ausência é uma escolha metodológica: comparar diretamente estudos com rótulos, populações, scanners, prevalências e validações diferentes poderia produzir uma estimativa enganosa.
Utilidade clínica, limitações e o que não se pode concluir
A utilidade potencial é ampla: detectar anormalidades, segmentar lesões, quantificar volumes, priorizar filas de urgência, classificar doenças, apoiar diagnóstico diferencial, graduar tumores, estimar estágio e integrar dados multimodais. Em AVC, isso pode acelerar triagem; em tumores, padronizar segmentação; em demência, combinar atrofia, conectividade, PET, cognição e longitudinalidade.
Mas a revisão enfatiza que discriminação retrospectiva não basta. Modelos precisam manter desempenho fora da base de desenvolvimento, separar pacientes corretamente, lidar com scanners e protocolos diferentes, reconhecer incerteza e funcionar quando prevalência e composição clínica mudam. Vazamento por divisão em fatias, sobreposição de pacientes, seleção de features antes da validação e adaptação excessiva a benchmarks pode inflar resultados.
Sobre importância das features, a evidência é descritiva. MRI foi mais representada e multimodalidade cresceu, mas isso não prova que MRI seja sempre melhor nem que adicionar modalidades sempre melhore decisões. Também não se pode transformar mapas de saliência, atenção ou ranking de variáveis em explicação causal da doença. A revisão diferencia explicação do modelo de inferência neurobiológica.
Em suma, o campo é promissor, mas ainda imaturo para conclusões universais. O que falta não é apenas arquitetura mais sofisticada: faltam relato transparente de features, validação externa, controle de vazamento, tratamento robusto de dados ausentes, avaliação prospectiva e demonstração de benefício clínico real.
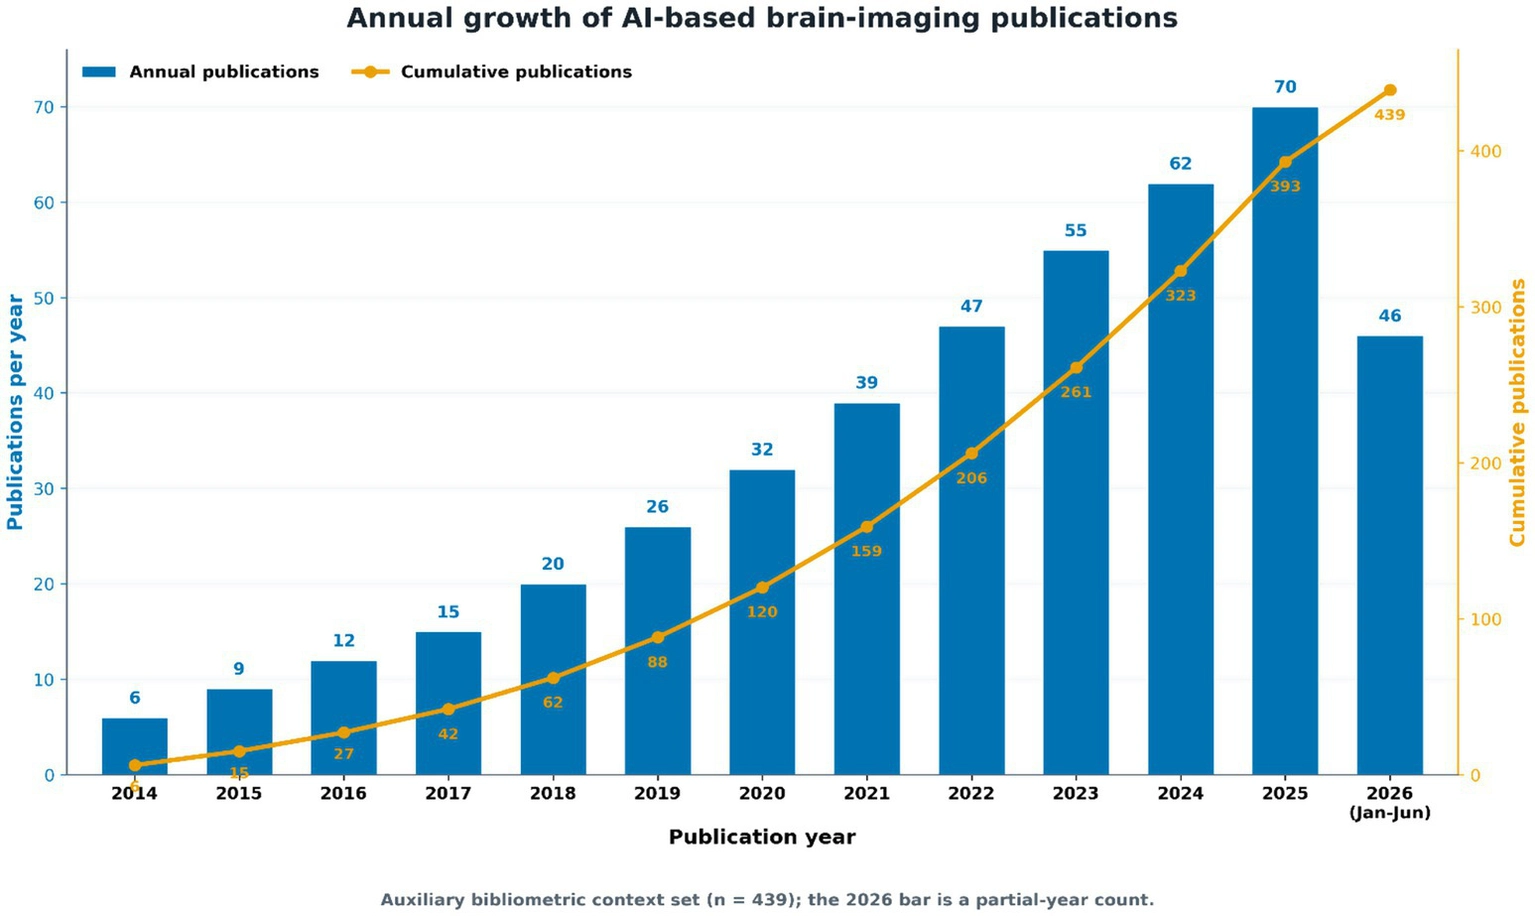
Annual distribution of AI-based brain-imaging publications in the auxiliary bibliometric mapping set. The annual bars assign each publication to one publication year, and the cumulative curve sums the same 439-publication set. This contextual set is separate from the 123-study PRISMA evidence base; 2026 covers January through June only.
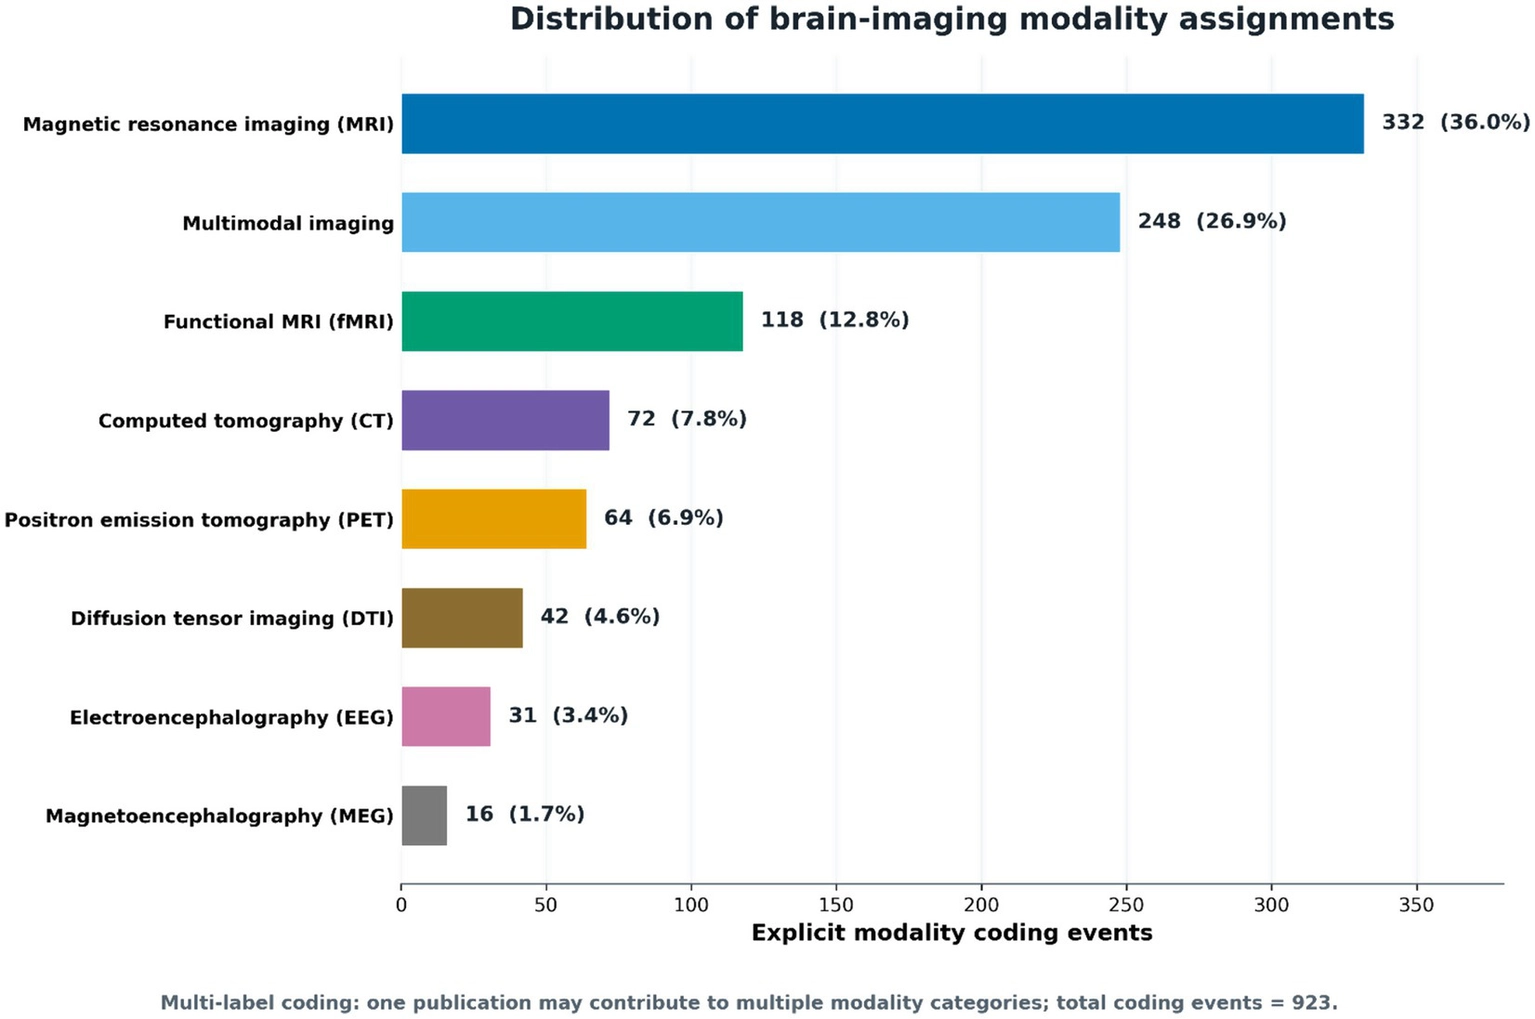
Distribution of brain-imaging modality assignments in the auxiliary mapping data. One coding event is one publication-to-modality assignment. Because a publication could be assigned to multimodal imaging and to each component modality, the 923 events are non-mutually exclusive and do not represent 923 independent studies.
Artigo original
Omarov B., Front Hum Neurosci, 2026-10-14
Imagens reproduzidas do artigo original sob a licença informada pelo periódico: This is an open-access article distributed under the terms of the Creative Commons Attribution License (CC BY). The use, distribution or reproduction in other forums is permitted, provided the original author(s) and the copyright owner(s) are credited and that the original publication in this journa