- Published on
IA com MRI estrutural para detectar Alzheimer: o que o modelo realmente usa
- Authors
- Name
- Michel Fernandes
- @michelpf
A pergunta do estudo
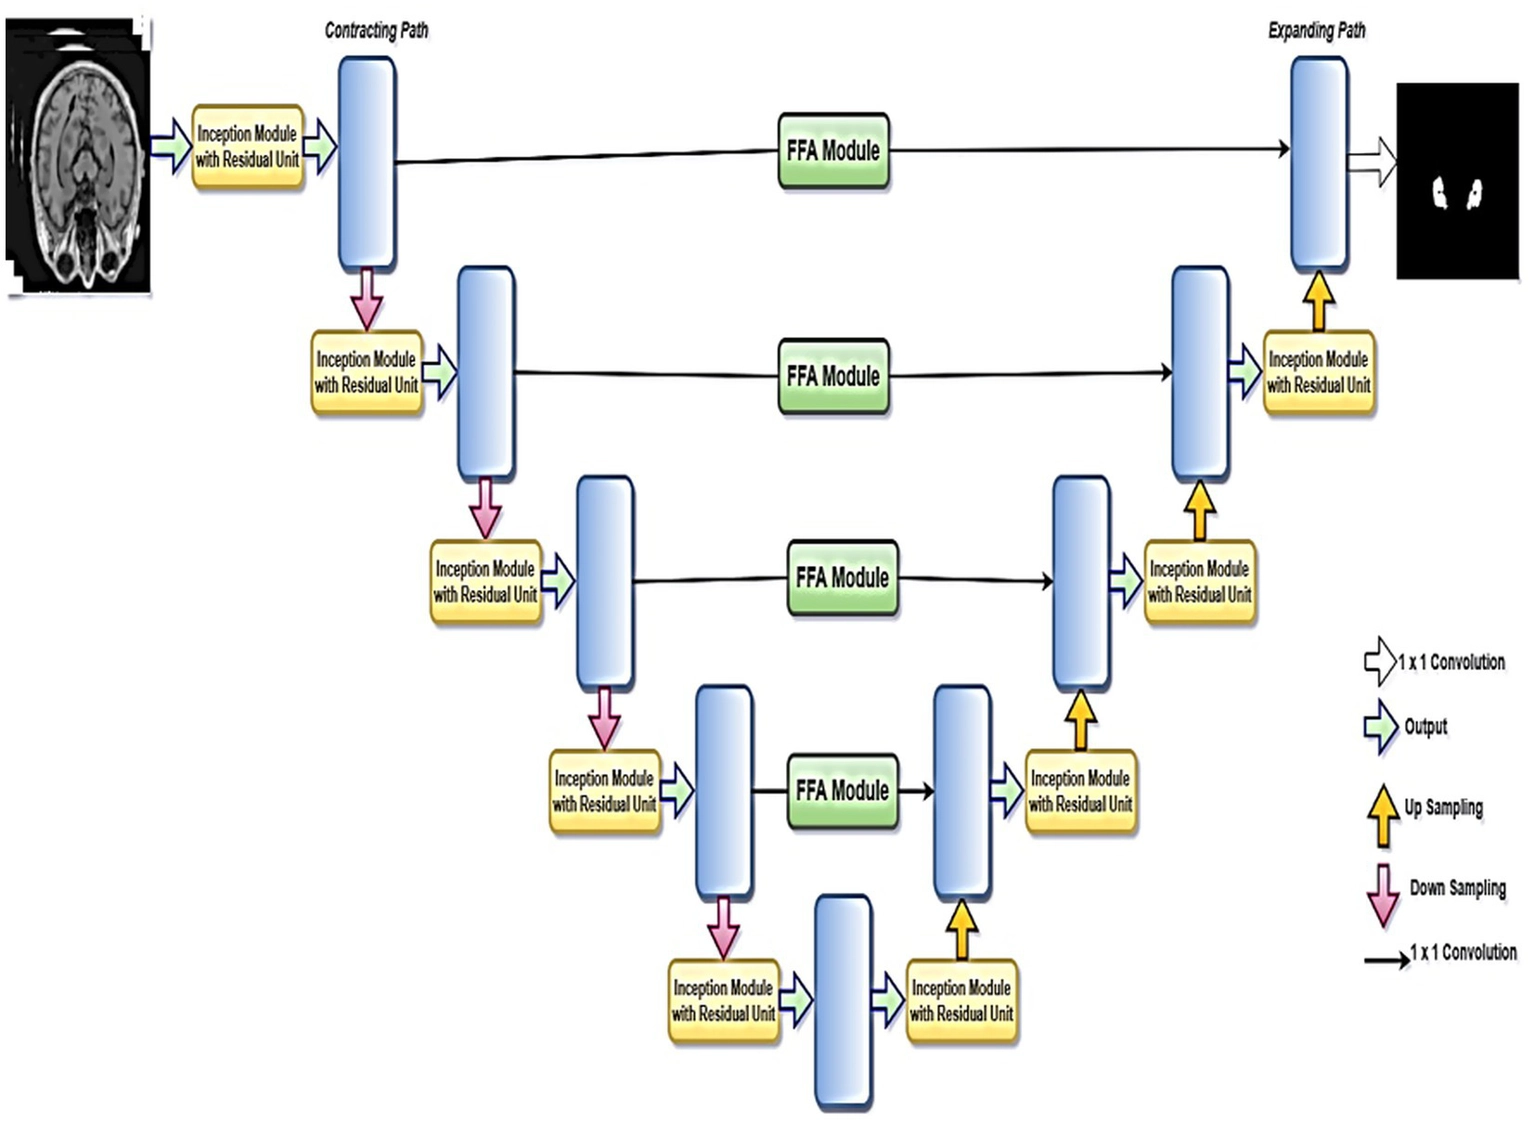
O estudo investiga se uma inteligência artificial pode distinguir pessoas com doença de Alzheimer (AD) de controles saudáveis usando imagens estruturais de ressonância magnética (MRI). A proposta tem duas etapas. Primeiro, uma rede chamada FFA U-Net segmenta, pixel a pixel, três grandes classes de tecido cerebral: substância cinzenta, substância branca e líquido cefalorraquidiano. Depois, os mapas produzidos nessa segmentação são combinados com a MRI original e enviados a uma VGG16, rede que entrega a classificação final: AD ou controle saudável.
A hipótese de trabalho é que a segmentação ofereça uma orientação anatômica ao classificador. Em vez de procurar padrões em toda a imagem, incluindo fundo, regiões fora do cérebro e possíveis artefatos, a segunda rede recebe também uma representação organizada dos tecidos. Isso pode ajudar o sistema a aprender diferenças estruturais entre os grupos estudados.
Mas a pergunta respondida é limitada. O artigo avalia uma classificação binária em bases públicas de pesquisa. Não demonstra que a ferramenta diagnostique Alzheimer em qualquer pessoa na prática clínica, detecte a doença antes dos sintomas, diferencie Alzheimer de todas as outras causas de demência ou substitua avaliação médica, testes cognitivos e biomarcadores.
Quem compõe os dados: ADNI e OASIS
Foram usados dois bancos públicos de neuroimagem: ADNI e OASIS. O texto informa 843 imagens no ADNI, divididas em 506 para treinamento, 168 para validação e 169 para teste. No OASIS, foram 416 imagens: 250 no treinamento, 83 na validação e 83 no teste. Os autores declaram haver um volume de MRI estrutural por participante.
Um ponto metodológico positivo é a divisão por participante. Segundo o artigo, um mesmo indivíduo não aparece em mais de uma divisão. Isso reduz o risco de vazamento de dados: se imagens, cortes ou exames da mesma pessoa estivessem no treino e no teste, a IA poderia reconhecer características daquele indivíduo, e não padrões que se repetem em pacientes novos.
O trecho disponível, porém, não traz detalhes sobre idade, sexo, escolaridade, raça ou etnia, gravidade clínica, critérios diagnósticos, protocolos de MRI, fabricantes dos equipamentos ou centros participantes. Também não há desempenho por subgrupos. Sem essas informações, não é possível saber se os resultados se manteriam em populações diversas ou em serviços com diferentes scanners e rotinas de aquisição.
A tarefa é AD versus controle saudável. O estudo não testa diretamente comprometimento cognitivo leve, risco de progressão futura, demência vascular, demência frontotemporal, demência por corpos de Lewy, depressão, doenças cerebrovasculares ou outras situações que tornam o diagnóstico real mais complexo.
Features e variáveis de entrada: o que a IA recebe
Este é um modelo de imagem, e não um sistema clínico multimodal. O artigo não relata usar idade, sexo, escolaridade, resultados de MMSE ou CDR, escalas funcionais, PET, líquor, genética como APOE, biomarcadores sanguíneos, medicamentos ou histórico médico como entradas. Mesmo que algumas dessas informações possam existir nas coortes, não se pode supor seu uso: o método descrito se baseia em MRI estrutural e em representações derivadas dela.
A primeira entrada é a MRI estrutural cerebral. O trabalho descreve cortes bidimensionais padronizados para 256 × 256 pixels. Cada pixel contém uma intensidade de sinal da MRI. Juntos, os pixels preservam forma, contornos, contraste entre tecidos e relações espaciais. Contudo, a rede não recebe medidas clínicas prontas, como volume do hipocampo, espessura cortical ou volume ventricular. Ela aprende padrões diretamente das imagens processadas.
A segunda entrada é o conjunto de mapas de tecido gerado pela FFA U-Net: substância cinzenta, substância branca e líquido cefalorraquidiano. O artigo alterna os termos “mapas de probabilidade” e “máscaras de segmentação”. Em ambos os casos, a intenção é representar, em cada posição do corte, a associação daquele pixel com uma das classes de tecido. Esses mapas funcionam como uma camada anatômica adicional sobre a MRI original.
O texto afirma que MRI e mapas de tecidos são combinados antes da VGG16, mas não especifica de forma inequívoca o formato final: não informa claramente quantos canais entram no classificador, se os três mapas permanecem separados ou como a fusão é implementada. Esse detalhe não deve ser inferido. Ele importa porque influencia quais informações a VGG16 pode distinguir e como seria possível reproduzir o experimento.
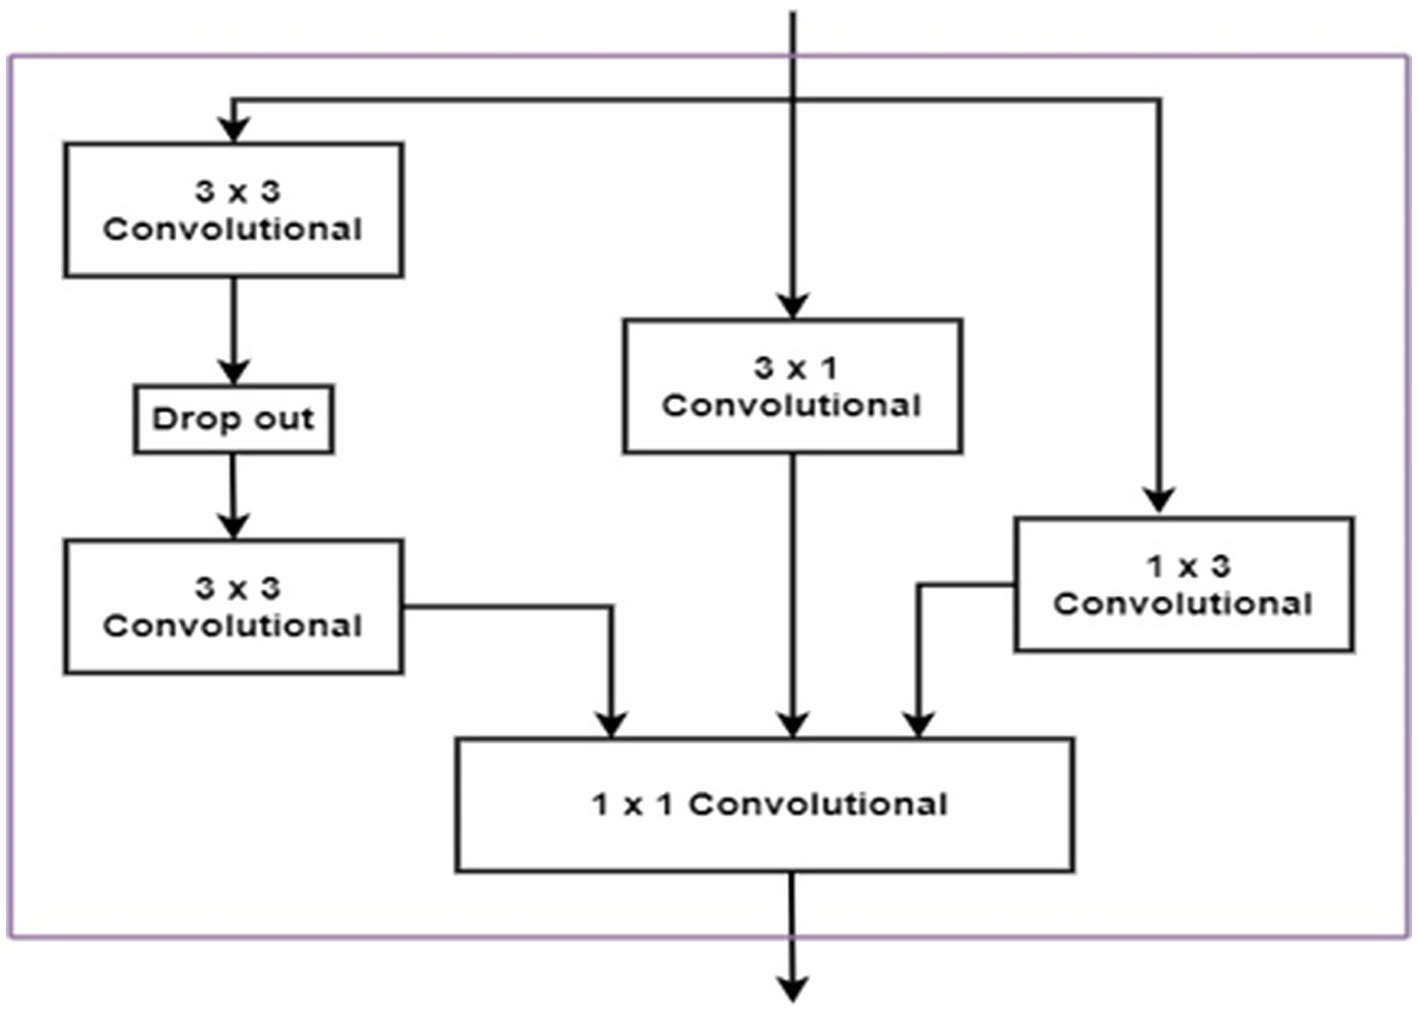
Há ainda features internas aprendidas pelas redes. A FFA U-Net usa filtros convolucionais 1 × 3, 3 × 1 e 3 × 3. Eles procuram padrões locais de intensidade e bordas em escalas e direções diferentes. Isso não quer dizer que um filtro seja uma variável anatômica identificável: são conjuntos de pesos numéricos otimizados durante o treinamento. A rede contém cinco blocos codificadores, quatro decodificadores e quatro conexões de atalho.
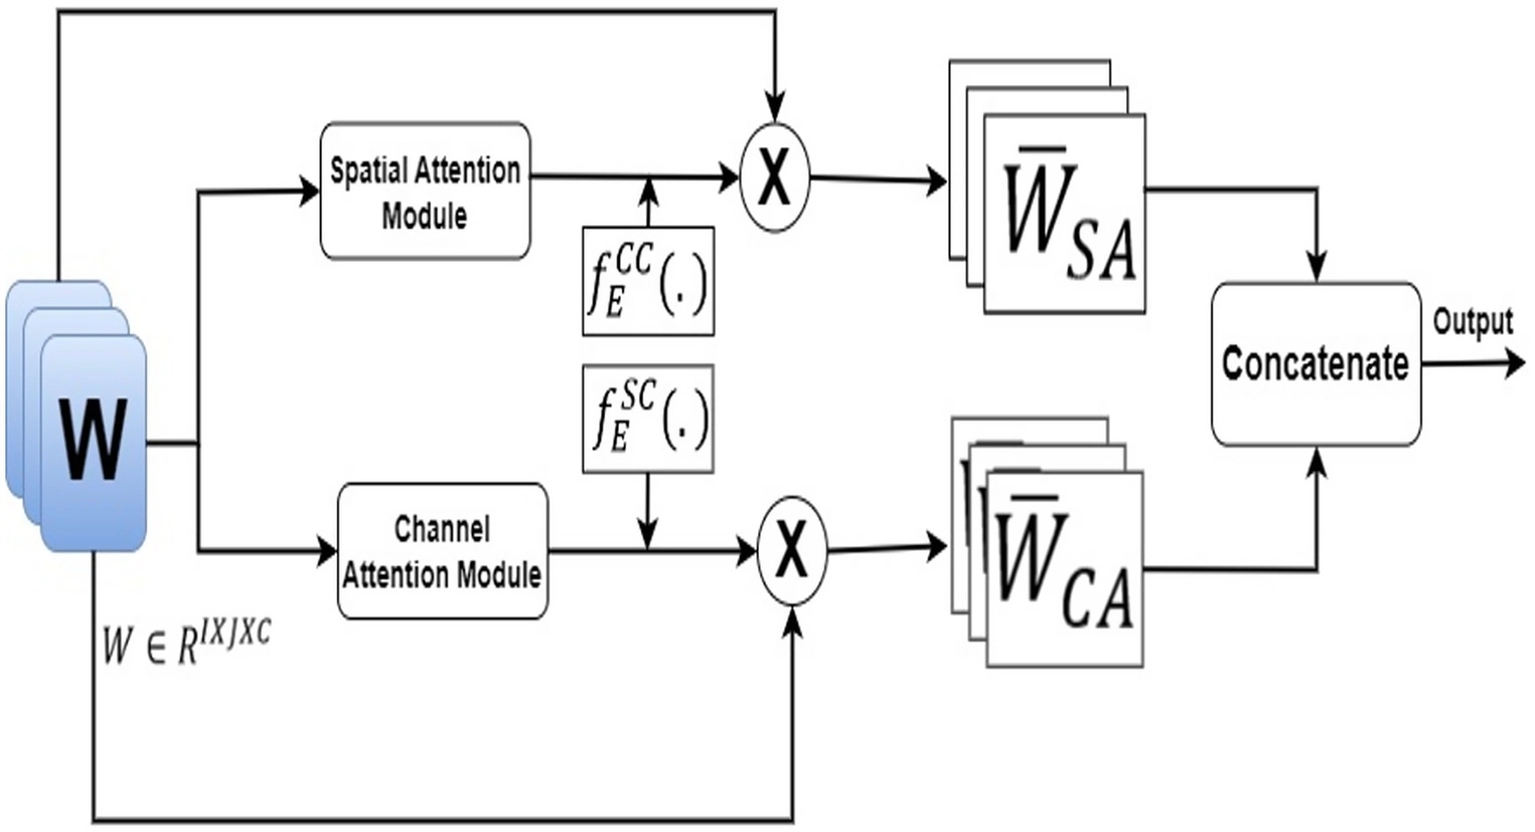
Nessas conexões, a arquitetura aplica atenção espacial e atenção por canais. A atenção espacial repondera posições dos mapas internos: determinadas localizações podem receber maior peso. A atenção por canais repondera os próprios mapas de ativação internos, usando pooling global e duas camadas totalmente conectadas. As duas formas de atenção são fundidas por soma residual. Trata-se de seleção automática de informação dentro da rede, não de uma lista de variáveis clínicas com importância previamente definida.
Como as features foram preparadas e selecionadas
As intensidades foram normalizadas para o intervalo de 0 a 1 usando o mínimo e o máximo da imagem. Esse passo torna escalas numéricas mais comparáveis para o treinamento. Contudo, não demonstra que diferenças causadas por scanner, sequência de aquisição ou centro tenham sido eliminadas. As imagens foram redimensionadas por interpolação bilinear para 256 × 256 pixels. O trecho não informa resolução original, orientação dos cortes, espessura, registro espacial entre participantes ou se todos os cortes de cada volume foram usados.
As referências para treinar a segmentação não eram máscaras manuais de especialistas. Os autores afirmam que as produziram com FSL-FAST, usando imagens com remoção de crânio e normalização de intensidade. Portanto, a FFA U-Net foi treinada para aproximar segmentações automatizadas de substância cinzenta, branca e líquido cefalorraquidiano. Os autores reconhecem não ter realizado inspeção visual ou controle manual de qualidade dessas máscaras. Uma métrica alta de segmentação, nesse contexto, indica concordância com a referência gerada pelo FSL-FAST, não necessariamente validação contra um padrão manual independente.
O aumento de dados foi aplicado somente no treinamento: espelhamento horizontal aleatório, rotações de até 10 graus, variações de intensidade e pequenas translações. Validação e teste não receberam essas modificações. O modelo usou também normalização em lote, LeakyReLU e dropout de 0,5. Os autores relatam ter comparado valores de dropout de 0,3, 0,5 e 0,7, selecionando 0,5.
Não foi descrita seleção convencional de features, como LASSO, PCA, testes estatísticos, ranking de medidas anatômicas ou eliminação de variáveis. A seleção ocorre implicitamente: convoluções transformam os pixels em mapas internos; operações de redução comprimem informação; atenção espacial e por canais repondera essas representações; e a VGG16 produz a decisão final. Os quatro primeiros blocos convolucionais da VGG16 foram congelados, enquanto o quinto foi ajustado aos dados. A cabeça original foi trocada por três camadas totalmente conectadas para a classificação binária.
Os autores relatam cerca de 8,6 milhões de parâmetros treináveis na FFA U-Net e 15,2 milhões na VGG16 ajustada. Esses números não representam quantas features interpretáveis existem. São pesos matemáticos distribuídos nas camadas. O artigo não informa o número de ativações finais nem fornece uma lista de features que “chegaram” à decisão clínica.
Resultados quantitativos e contribuição das features
A segmentação foi avaliada por coeficiente Dice, índice de Jaccard e distância de Hausdorff. Dice e Jaccard medem sobreposição entre máscara prevista e referência; Hausdorff mede discrepâncias de contorno. A classificação AD versus controle usou acurácia, sensibilidade, especificidade, precisão e AUC-ROC.
A FFA U-Net foi comparada com U-Net, U-Net++ e MultiRes U-Net sob condições de treinamento que os autores dizem ter padronizado. O texto também menciona resultados acima de 98% de acurácia e AUC superior a 0,99. Porém, o material fornecido termina antes das tabelas de resultados. Não há valores completos verificáveis por base, intervalos de confiança, matrizes de confusão, contagens de falsos positivos e falsos negativos ou desempenho por subgrupo. Por isso, não é possível apresentar essas menções gerais como evidência quantitativa completa.
A evidência sobre contribuição de features é principalmente arquitetural. A classificação recebe a MRI original e os mapas dos três tecidos; a segmentação utiliza mecanismos de atenção que reponderam posições e canais internos. Isso mostra o que o sistema foi projetado para receber e transformar. Não mostra, porém, qual informação foi decisiva em cada previsão.
O artigo fornecido não apresenta análises de ablação retirando substância cinzenta, substância branca ou líquido cefalorraquidiano separadamente. Também não traz SHAP, Grad-CAM, mapas de saliência, ranking de pixels, ranking de regiões cerebrais ou quantificação de importância de cada canal. Portanto, não se pode afirmar que a substância cinzenta foi a variável mais importante, que o líquido cefalorraquidiano explicou o desempenho ou que o modelo dependeu mais do hipocampo, do córtex entorrinal ou de qualquer região específica. Essas hipóteses podem ser plausíveis, mas não foram demonstradas aqui.
Utilidade clínica, limites e o que ainda não se conclui
Uma aplicação futura possível seria apoio à análise de MRI, como segunda leitura ou ferramenta de pesquisa. Ao juntar a MRI a mapas automatizados de tecidos, o sistema pode gerar uma classificação baseada em uma representação anatômica mais estruturada. Mas o estudo não mostra que médicos tenham melhorado decisões com a ferramenta, que pacientes tenham tido melhores desfechos, que o tempo diagnóstico tenha diminuído ou que o sistema tenha sido avaliado prospectivamente em hospitais.
Há limites importantes. Os mapas de tecidos e a MRI original são fontes parcialmente redundantes, pois os mapas são derivados da própria MRI. Eles não equivalem a confirmação independente por PET, líquor ou genética. Além disso, erros sistemáticos do FSL-FAST podem ser incorporados na segmentação e, em seguida, influenciar a classificação.
Os autores relatam precauções contra vazamento: separação por participante, escolha de arquitetura e hiperparâmetros na validação e ausência de uso do teste para estatísticas de pré-processamento. Ainda assim, um único particionamento com semente fixa 42 não substitui validação repetida, intervalos de confiança ou teste externo independente. O trecho não descreve de modo claro um cenário em que o modelo treinado em uma base tenha sido testado integralmente na outra.
As comparações com estudos anteriores são indiretas, porque cada trabalho pode usar participantes, imagens e pré-processamentos diferentes. Logo, elas não demonstram superioridade estatística do método.
A conclusão adequada é restrita: o estudo propõe uma forma tecnicamente coerente de combinar MRI estrutural e mapas automatizados de tecidos para classificar AD versus controles. Os autores relatam desempenho alto, mas a interpretação exige as tabelas completas e confirmação por validação externa, referências de segmentação mais rigorosas e estudos prospectivos. Ainda não se pode concluir que a ferramenta faça diagnóstico individual, detecte Alzheimer pré-sintomático ou seja confiável em populações e hospitais diferentes.
Inception module.
Feature fusion attention module.
Artigo original
Panabakam N, Elangovan K, Seerangan K, Manogaran N, Malleeswaran K, Yogarayan S., Front Neurosci, 2026-09-03
Imagens reproduzidas do artigo original sob a licença informada pelo periódico: This is an open-access article distributed under the terms of the Creative Commons Attribution License (CC BY). The use, distribution or reproduction in other forums is permitted, provided the original author(s) and the copyright owner(s) are credited and that the original publication in this journa